


2026 OCP Global Summit | NVIDIA | Ajay Kamalvanshi | Every Megawatt Counts: DSX MaxLPS
1. 為何是這場演講
講者 Ajay Kamalvanshi 是 NVIDIA GPU 系統軟體資深總監,2009 年進公司時做的是 GPU Boost 與筆電的 Max-Q,也就是「在固定功耗或散熱上限內榨出最高效能」。十七年後,同一套思路從一顆 GPU 放大到一整座資料中心:MaxLPS 的 LPS 指的是 Land、Power、Shell,土地、電力、建築外殼。
開場引用的是黃仁勳在 GTC 26 的一句話:每一瓦沒用到的電,都是損失的營收。NVIDIA 把 AI 工廠比成五層蛋糕,最底層是能源、最上層是應用,目標是把電網送進來的每一瓦都轉成 token。
這和同一場大會上光通訊廠的論述是同一件事。Credo 用電力合約回推每瓦約 100 美元的機會成本,我們在 法說精華:Credo(CRDO)|Q1 FY2027 也拆過它押注光學的營收結構;OIF 也已把 pJ/bit 寫進官方需求,見 OIF 替 AI 互連畫了張官方地圖。差別在於,光通訊廠是從元件端省瓦,NVIDIA 是從調度端「回收」瓦。
電力已經取代矽,成為 AI 工廠營收的天花板。
2. 拆解問題:電被「最壞情況」鎖住
今天的機櫃是按銘牌功率(nameplate)配電:每顆 GPU 都假設跑在 Max-P。但 NVIDIA 在 GB300 上量到的推論功耗(不設功耗上限)完全不是這回事:
DeepSeek-R1 約 1,040 W、GPT3-175B 約 1,060 W,最接近上限的兩種負載,仍比 1,400 W 的 Max-P 低約 25%。
Mixtral 8x7B 約 850 W,Qwen3-235B 約 710 W,只用掉一半。
連 1,100 W 的 Max-Q 線,四種負載都沒有碰到。

▲ GB300 實測四種推論負載的單顆 GPU 功耗,全部低於 1,400 W Max-P 與 1,100 W Max-Q(圖片來源:NVIDIA|2026 OCP Global Summit 簡報(03:21))
單櫃層級的例子更直接。以 GB200 跑 Kimi-K2.5(FP4、Dynamo、TRT-LLM、8K/1K)為例:
機櫃功率 | MaxP | MaxLPS |
GPU TGP 設定 | 1,200 W | 800 W |
機櫃配置功率 | 120 kW | 90 kW |
吞吐量 | 1x | 相同 |
同電力可放機櫃數 | 1x | 多 33% |
TGP 從 1,200 W 降到 800 W,吞吐量不變,等於 120 kW 除以 90 kW,同一個電力包絡多放 1.33 倍機櫃。
3. 拆解證據:從一櫃到一座 1 GW
NVIDIA 用四個層級的數字堆出同一個結論。最有說服力的是機櫃群這一層:四櫃 GB300 分別跑 DeepSeek-R1、Qwen3-235B、GPT3-175B、Mixtral-8x7B,總預算 540 kW、每櫃配 135 kW,實耗合計只有 330 kW,210 kW 被閒置。改成動態配電後,同一個 540 kW 多開第五櫃,實耗升到 425 kW。

▲ 540 kW 預算下,靜態配電閒置 210 kW;MaxLPS 動態配電在同一預算內多開一櫃,實耗 425 kW(圖片來源:Simple Tech Trend 自製,資料來源 NVIDIA 2026 OCP Global Summit 簡報)
層級 | 情境 | 增量 | 來源 |
單櫃 | GB200、Kimi-K2.5 推論 | 機櫃 +33% | 投影片 |
機櫃群 | GB300、540 kW、四種負載 | 4 櫃變 5 櫃(+25%) | 投影片 |
客戶 | Nscale | GPU +37%、perf/W 約 +48% | 口頭,引用 NVIDIA 部落格 |
1 GW 模擬 | DSX Sim | 274,968 顆變 399,096 顆(+45%) | 投影片截圖 |
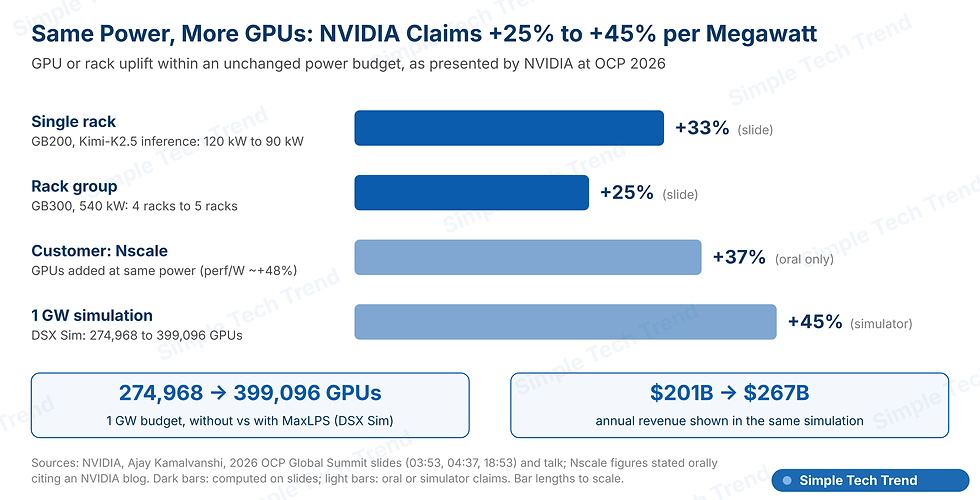
▲ 同一電力預算下 MaxLPS 宣稱的 GPU 增量,從單櫃 +33% 到 1 GW 模擬 +45%(圖片來源:Simple Tech Trend 自製,資料來源 NVIDIA 2026 OCP Global Summit 簡報)
要注意的是,層級越高、數字越漂亮,可驗證性也越低:+33% 與 +25% 有完整的投影片計算,+37% 只出現在口頭,+45% 是模擬器畫面。Lambda 則只給了一段 Dave Ward 的背書引言,沒有數字。
4. 架構拆解:Dynamic Power Software 的四件事
MaxLPS 的核心是跑在資料中心管理節點上的 Dynamic Power Software(DPS),做四件事:
階層式電力約束:從設施設計規格或 BMS(建築管理系統)匯入電力拓撲,從 CPU、GPU、機櫃、SU(scalable unit)到 DU(deployable unit)逐層設定斷路器上限,保證任何時刻都不越線。
閉迴路控制:透過 OOB(頻外)Redfish 讀功耗、設上限,不干擾正在跑的負載。判斷規則很簡單:實耗比配額低 20% 以上就收回,進入 5% 以內就補給,5% 到 20% 之間不動。
和 OT 端協調:電網可用 OpenADR 發降載訊號,例如亞利桑那的熱天;Emerald AI 這類 ISV 幫忙找電網裡的閒置電力,NVIDIA 宣稱北美有 100 GW 可解鎖;Phaidra 這類 AI 代理則負責優化 CDU(冷卻分配單元),省下的冷卻電力可以挪給 IT。
負載優化:在 GPU 內部各 IP 單元之間、GPU 與 CPU 之間、GPU 與 NVSwitch 之間搬功耗,並把策略接進 Dynamo 推論框架,依 prefill、attention、decode 階段調度。

▲ MaxLPS 每個節點的決策規則:低於配額 20% 收回、逼近 5% 補給、5% 到 20% 不動(圖片來源:NVIDIA|2026 OCP Global Summit 簡報(10:13))
超賣電力最大的疑慮是 SLA。NVIDIA 的答案是三級優先序:P0 是前沿模型訓練,用 Max-P 配電;P1 是重視延遲、客戶付費買 SLA 的 premium/ultra 區段,依需求配電、優先 boost;P2 是價值型區段,用 Max-Q。降載事件發生時,先把 P2 壓到地板(投影片範例是每櫃 50 kW),不夠再壓 P1、再壓 P0,最後才停工作,事件結束後恢復。
5. 真正的挑戰:遙測太慢
閉迴路控制器的上限,取決於它多快看到電。Kamalvanshi 很坦白:這套東西原本在 NVIDIA 內部做,開始和 NCP(NVIDIA 雲端夥伴)合作後才發現,現場設備回報的遙測不夠可靠、延遲太高。現在的電力設備多半只有 Modbus 或 Redfish,本來就不是為快速功耗遙測設計的。
NVIDIA 的對策有三條:
和 BMC 韌體夥伴一起改善 Redfish 介面的延遲與可靠度,並提供測試套件給夥伴採用。
在 OCP GPU Management Interfaces 工作小組推動改用 UDP 串流遙測,規格已進 v2.0.0,NVIDIA 貢獻 Zapp 作為參考實作。
把快速遙測延伸到 PQM 與 BESS 等電力設備,直接接上系統管理堆疊。

▲ NVIDIA 列出的四項挑戰與合作方向,右側為 DSX Sim 在 1 GW 預算下的 GPU 數與年營收對照(圖片來源:NVIDIA|2026 OCP Global Summit 簡報(18:53))
MaxLPS 會隨 Vera Rubin 一起上市,屬於 DSX 參考堆疊的一部分,和已開源的 NICo(NVIDIA Infrastructure Controller)、多租戶的 Launch Layer 整合;投影片寫的目標是擴展到 1 GW 資料中心。沒有機房的人可以先下載 DSX Sim 模擬。
6. 風險與反面論點
超賣就是押注負載不會同時衝高。四種負載同時接近 Max-P 的情況,例如大規模訓練切入,就只能靠節流解決;這對付費客戶的 SLA 是真實成本,NVIDIA 沒有給出節流頻率或效能損失的數字。
省下的是「配置」,不是「實耗」。540 kW 的例子裡實耗從 330 kW 升到 425 kW,電網看到的負載是增加的。對電費與冷卻而言,MaxLPS 讓機房更滿,不是更省。
功耗動態變大。更高的平均利用率加上快速的配額調整,代表機房負載起伏更頻繁。演講沒有談 800V DC 或電力平滑(power smoothing),但把 BESS 列進遙測範圍,暗示儲能在這套架構中會從備援角色變成控制元件。
數字的可驗證性分層:+37% 與 perf/W 約 48% 只在口頭出現,+45% 來自模擬器截圖,發布前應以 NVIDIA 官方部落格核對。
鎖定效應:DPS、DSX Exchange、Zapp 都是 NVIDIA 的軟體,雖然介面對齊 OCP,但調度權實際上從營運商移到了 NVIDIA 的堆疊裡。
7. 對台灣供應鏈的意義
伺服器 BMC 是第一個被點名的環節。NVIDIA 直接要求 BMC Redfish 的延遲與可靠度要改善,並提供測試套件。台灣的信驊是全球伺服器 BMC 晶片的主要供應商,搭載 BMC 的 AI 伺服器整機也多由台系 ODM 組裝,MaxLPS 的閉迴路好不好用,相當程度取決於這一層。
電源設備要從「供電」升級成「回報」。投影片列出的 PQM、RPP(機櫃配電盤)、UPS、CDU、BESS,都要能用快速串流遙測回報給 DPS。對台系電源、UPS、儲能與液冷廠商而言,規格書上除了效率與功率密度,接下來會多一欄「遙測延遲」。
散熱的論述會改變。Phaidra 一類的 AI 代理會把 CDU 省下的電挪給 IT,冷卻設備的價值從「散多少熱」轉向「能被調度多少」。若要對接這套體系,台系液冷廠需要開放控制介面,而不只是硬體。
每 MW 機櫃數上升是量的利多。同一座機房若能多放 25% 到 33% 的機櫃,伺服器、機櫃電源與液冷分歧管的需求跟著放大;但每櫃配置功率下修,也代表「每櫃越來越高瓦數」的單一敘事要打折。這部分是我們的推論,NVIDIA 並未給出供應鏈數字。
8. 總結
MaxLPS 本身不是硬體,但它改寫了 AI 工廠的規劃單位:從「每櫃幾 kW」換成「每 MW 幾顆 GPU」。投影片上能完整驗算的是單櫃 +33% 與機櫃群 4 變 5,這兩個數字已經足以說明,過去以銘牌配電的機房有兩成五到四成的電被鎖住。
時間點很清楚:MaxLPS 綁著 Vera Rubin 一起上市,hyperscaler 與 NCP 夥伴已在跑 PoC 與推論試點。接下來 12 個月該盯三件事:OCP 遙測規格 v2.0.0 何時被主流 BMC 與電源設備實作、NVIDIA 是否公開降載事件下的 SLA 損失數據、以及 Nscale 之外有沒有第二家客戶公布可驗證的 GPU 增量。
在電力被鎖死的時代,最便宜的新電廠,是機房裡那 39% 沒被用到的電。
本文僅供技術與產業趨勢分析,不構成任何投資建議。


留言