


2026 OCP Global Summit | Credo | LK Bhupathi | Going Wide: Scalable and Reliable Optical Interconnects
1. 百萬 GPU 叢集,每 6 分鐘壞一顆光模組
這場是 Expo Hall 的技術場,講者 LK Bhupathi 開場就把問題講白:AI 叢集擴張的限制不只是功耗與密度,還有可靠度。單一元件再可靠,乘上十萬、百萬顆之後,叢集層級的可靠度會快速崩壞。
Credo 的投影片用一張表把這件事量化。假設每顆 GPU 1,500 W、三層 CLOS 網路、每四條 scale-out 鏈路配一條前端鏈路,光埠 MTBF 取 Meta 在 2025 OCP 公布的 55 萬小時:
叢集電力/XPU 數 | 光收發器數量 | 平均多久壞一顆 |
30 MW/2 萬 | 超過 10 萬 | 5 小時 |
300 MW/20 萬 | 超過 100 萬 | 30 分鐘 |
1.5 GW/100 萬 | 超過 500 萬 | 6 分鐘 |

▲ Credo 以 55 萬小時光埠 MTBF 推算,百萬 XPU 叢集每 6 分鐘就有一顆光模組失效(圖片來源:Credo|2026 OCP Global Summit 簡報(05:30))
換算成一年:每小時 10 顆、每天 240 顆、一年約 8 萬顆。投影片的副標寫得更直接:One Bad Link, Hundreds of Stranded GPUs。一條鏈路出事,被拖住的不是一台伺服器,而是同一個集合通訊群組裡的上百顆 GPU。
而 AWS 在印第安納州 New Carlisle 的資料中心預計容納約 100 萬顆 XPU,業界已經在談兩倍、三倍規模的園區。照這個斜率,光模組失效會從維運問題變成產能問題。
2. 為什麼 link flap 比斷線更糟
Credo 的基準是自家 AEC(主動電纜):出貨多年、1 億小時 MTBF,比 Meta 回報的光學 MTBF 高約兩個數量級(1 億除以 55 萬約 180 倍)。問題於是變成:光學能不能做到銅等級的可靠度?
第一層答案是 ZeroFlap PHY 層遙測。Bhupathi 特別點出最糟的失效型態不是「壞掉」,而是 link flap(鏈路抖動):鏈路沒有完全斷,也沒有完全起來,起來又掉、掉了又起來,上層的路由與集合通訊反覆重算,整個網路無法收斂。
ZeroFlap 的做法是在 PHY 層內建一條管理通道(management channel),兩端 MCU 持續交換每個通道的健康資訊,在通道真正失效之前就偵測到衰退。這延續 Credo 在 AEC 時代建立的路線,我們在 法說精華:Credo(CRDO)|Q1 FY2027 也看過,ZeroFlap 與 PILOT 診斷平台已經是 Credo 光學業務的主要賣點。
但只會預知還不夠。看到通道要壞,如果只能通知上層「準備斷線」,叢集還是要停。這就需要第二層。
3. 拆解 Layer Zero 備援:15% 備援通道換兩個數量級
第二層是 Layer Zero Redundancy,也是這場演講的核心。架構很直觀:
Host 介面進來後經過 gearbox,拆成 N 條 M Gbps 的慢速通道,再經 lane mapping 對應到二維發光陣列
陣列裡多數通道傳資料,約 15% 保留為備援(spare),另有通道專門跑管理訊號
某條資料通道開始衰退時,管理通道把健康資訊傳到對端,兩端晶片協同把資料切到備援通道
切換過程零資料遺失(hitless),發生在 OSI 第一層之下,上層工作負載不會察覺

▲ ZeroFlap 架構:PHY 層管理通道交換通道健康資訊,約 15% 備援通道做無中斷切換,目標 MTBF/MTBI 1 億小時(圖片來源:Credo|2026 OCP Global Summit 簡報(08:46))
簡單的說:傳統光模組靠「元件不要壞」換可靠度,Credo 靠「壞了也不用停」換可靠度。所以投影片同時寫了 MTBF(平均失效間隔)與 MTBI(平均中斷間隔),後者才是叢集營運真正在乎的指標。
把這個差距代回第一節的表,影響非常具體。若光學鏈路真的達到 1 億小時:
500 萬顆收發器的叢集,從每 6.6 分鐘一次失效,變成約每 20 小時一次
一年的中斷次數從約 8 萬次降到約 440 次

▲ 以 55 萬小時與 1 億小時 MTBF 推算三種叢集規模的失效間隔,百萬 XPU 叢集從約 6.6 分鐘拉長到約 20 小時(圖片來源:Simple Tech Trend 自製,資料來源 Credo 2026 OCP Global Summit 簡報)
4. 慢而寬為什麼天生適合做備援
備援不是新觀念,伺服器有 RAID、電源有 N+1。光學一直沒做,是因為快而窄的成本結構不允許:一顆 1.6T 模組只有 8 條 200G 通道,多放一條備援,光學通道就多 12.5%,還要多配一組雷射、驅動器與 DSP 通道。
慢而寬剛好相反。Credo 在投影片列了三個好處:
頻寬擴展:二維陣列可以同時增加通道數與縮小間距,每通道速率還有往上調的空間
光學可靠度:每個發光元件的電流密度較低、失效模式較少,備援通道便宜,且能無中斷切換
功耗:不用 PAM4 與複雜 DSP,簡單的 NRZ 調變即可,並內建光源

▲ Credo 列出寬平行光學在頻寬擴展、光學可靠度、功耗三項的優勢(圖片來源:Credo|2026 OCP Global Summit 簡報(10:38))
這裡的關鍵是「低電流密度」。我們在 ECOC2026 | 850nm 撐 1,600 小時就全掛,1060nm 跑到 5,000 小時零失效 拆過,VCSEL 陣列的壽命高度取決於操作條件。慢速通道讓每顆發光元件不必被推到極限,可靠度與功耗在同一個設計選擇裡一起改善,這是快而窄路線很難複製的。
5. 兩個產品:1.6T ALC 與 30 Pb/s 盲插背板
1.6T ZeroFlap ALC(Active Light Cable)是 Credo 宣稱的「史上最好的 scale-out 可插拔」:
MTBF 與 MTBI 皆 1 億小時,整合 PILOT 診斷
每端 12 W、50 公尺
對比自家 AEC:長 10 倍、輕 10 倍、功耗最多低 30%
2027 年量產(Volume in 2027)

▲ 1.6T ZeroFlap ALC:1 億小時 MTBF/MTBI、每端 12 W、50 公尺、2027 年量產(圖片來源:Credo|2026 OCP Global Summit 簡報(11:42))
50 公尺的意義是跨整排機櫃,把 GPU、CPU 與交換器直接串起來,這正是 AEC 碰不到、而雷射光模組可靠度又讓人頭痛的區段。
第二個是 ZeroFlap 盲插光背板,把今天 scale-up 背板上的銅纜換成光纖:
30 Pb/s、最多 100 萬芯光纖,透過盲插連接器自動完成連接
15% 過量配置(over-provisioning),光纖層級也能無中斷切換
使用 Senko 盲插連接器與 Credo 自家套圈(ferrule)
對比今天的銅背板:密度 30 倍(每個 tray 1.8 Pb)、距離 30 倍(50 公尺)、重量少 90%
宣稱零清潔、零維護
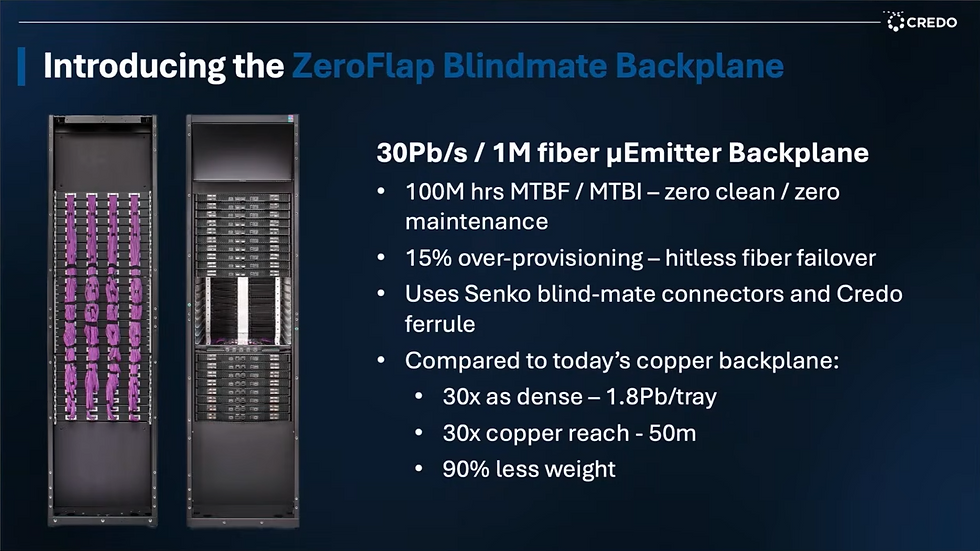
▲ ZeroFlap 盲插背板:30 Pb/s、100 萬芯光纖、15% 備援,密度與距離為銅背板 30 倍(圖片來源:Credo|2026 OCP Global Summit 簡報(14:06))
「零清潔」是這場最容易被忽略、但最有份量的一句。光纖連接最大的維運挑戰是端面污染與對位,殺死慢而寬的不是物理,是六萬條光纖 講的正是這件事。Bhupathi 的邏輯是:有備援,就不需要 100% 的通道都乾淨、都對準。備援從元件層延伸到光纖層,等於用架構去吸收組裝與維運的不完美。
6. 風險與反面論點
1 億小時是設計目標,不是現場數據。投影片寫的是「ZeroFlap Performance」,但目前沒有光學版本的大規模部署數據,要等 2027 年 ALC 出貨後才能驗證。
備援用完之後呢?15% 備援可以吸收逐步衰退,但如果是共用元件(gearbox、MCU、光源驅動)失效,備援通道救不了。Credo 沒有拆解哪些失效模式在覆蓋範圍內。
55 萬小時的基準可能偏悲觀。這是 Meta 回報的光埠數據,Credo 拿來代表整個光學陣營;新一代可插拔光模組若有改善,與 1 億小時的差距會縮小。
口頭數字未見投影片佐證。Bhupathi 口頭提到 CPO 背板相對銅背板最多省 60% 功耗、每櫃約 1,000 萬美元的機會成本,後者與同公司另一場主題演講的估算差距很大,投影片上沒有出現,宜保守看待。
CPO 時程未定。背板目前以 NPO 為基礎,CPO 版本只說「未來」,沒有給年份。
7. 對台灣供應鏈的意義
可靠度規格會從元件走向系統,驗證能力是門檻。當 hyperscaler 開始用 MTBI 而不是 MTBF 採購,供應商要能交出系統層級的遙測與失效數據。台灣的機櫃整合與測試業者,若要承接寬平行光學的組裝,得提早建立通道級別的老化與健康監測能力。
光纖數量增加 15% 是結構性的。備援不只在發光元件,也在光纖層。同樣頻寬下,線纜與背板組裝的芯數與連接器數都會變多,對線纜組裝是新增的產值,但對組裝良率與自動化的要求也更高。Credo 在同週主題演講公布的 SRMO 工作小組裡,組裝廠名單包含台系的 BizLink(貿聯-KY)與 Foxlink(正崴),值得追蹤兩家何時把 ALC 寫進營收。
盲插連接器這一段目前沒有台廠。這場明確點名的合作夥伴是日系的 Senko,套圈則是 Credo 自家設計。
8. 總結
這場演講把 Credo 慢而寬路線的另一半說清楚了:功耗是門票,可靠度才是護城河。當叢集走到百萬 XPU,光模組失效從每 5 小時變成每 6 分鐘,任何只靠「元件更好」的路線都追不上規模的斜率;Credo 的回答是把備援做進 Layer Zero,讓「壞了不用停」成為架構的一部分。
但 2027 年真正量產的只有 1.6T ALC,背板與 CPO 都還在展示階段。接下來 12 個月該觀察三件事:ALC 首批出貨的實際 MTBI、備援覆蓋的失效模式範圍、以及 hyperscaler 是否開始把 MTBI 寫進採購規格。只要第三件事發生,比較的規則就改了。
叢集越大,元件越不可能不壞;能活下來的互連,是那些壞了也不用停的。
本文僅供技術與產業趨勢分析,不構成任何投資建議。


留言