


ECOC2026 | 850nm 撐 1,600 小時就全掛,1060nm 跑到 5,000 小時零失效:Lumentum 用一張圖把 VCSEL 的戰場從速度移到了熱
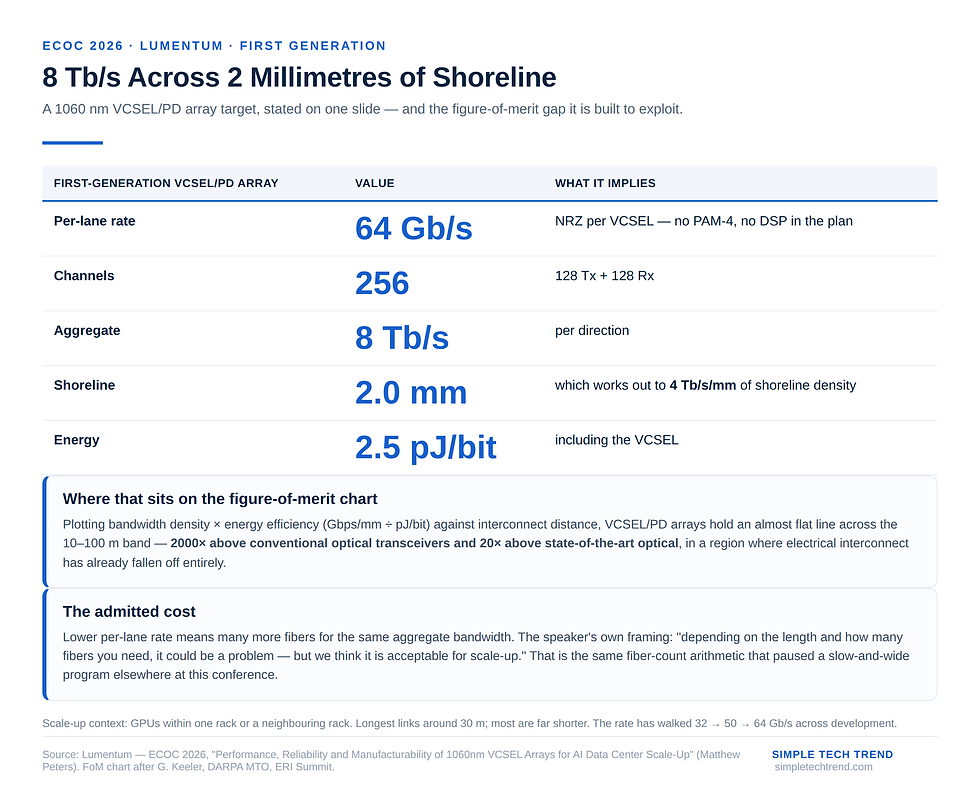
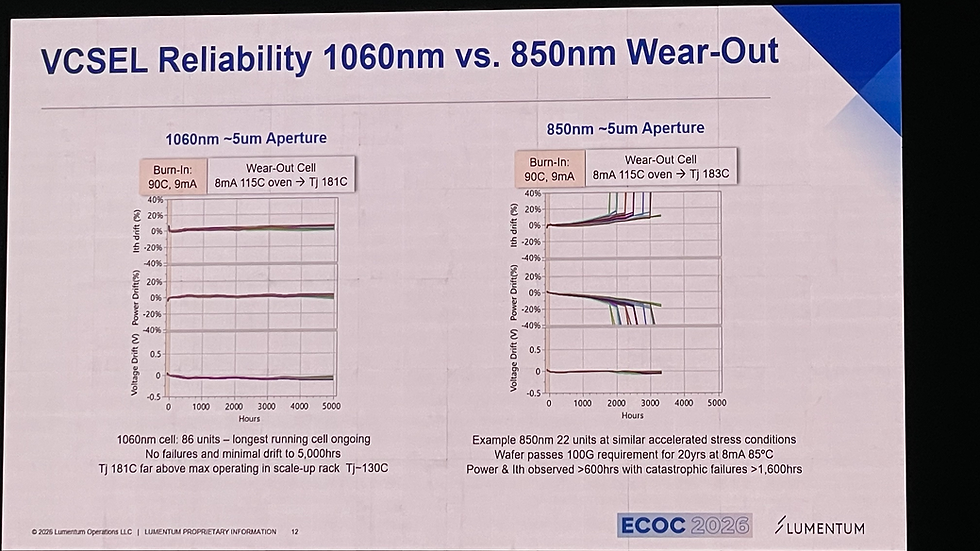
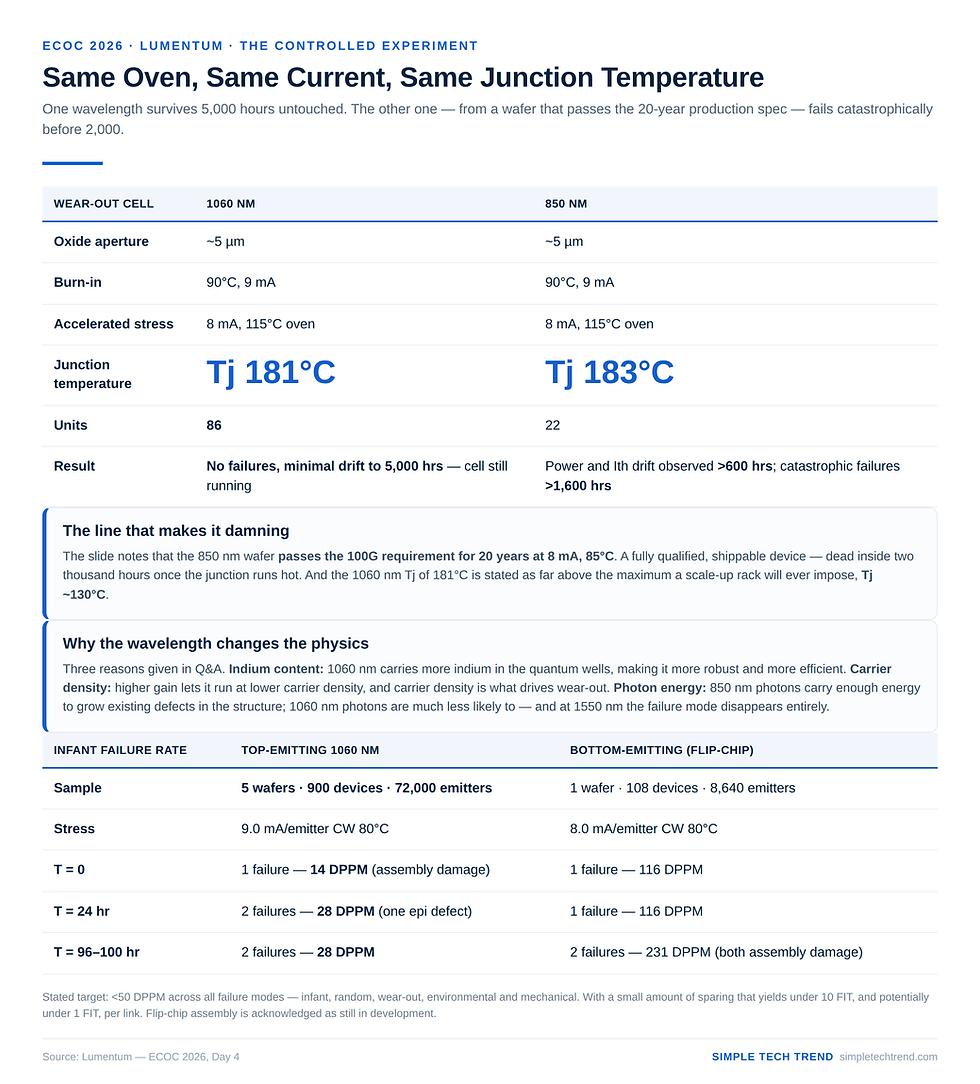
這場演講只有一張投影片真正重要,而它講的不是速度。Lumentum 做了一個非常乾淨的對照實驗——同樣約 5 µm 孔徑、同樣的燒機條件、同樣 8 mA 115°C 烤箱、接面溫度都在 181–183°C,左邊放 1060 nm、右邊放 850 nm。結果是:1060 nm 那組 86 顆跑到 5,000 小時,沒有任何失效、漂移極小;850 nm 那組 22 顆從 600 小時開始出現功率與臨界電流漂移,1,600 小時之後開始出現災難性失效。 而投影片特別註明:那片 850 nm 晶圓是通過「8 mA、85°C、20 年、100G」量產規格的。 換句話說,一顆合格的 850 nm 元件,在 scale-up 機櫃會遇到的熱環境下就是撐不住——而 1060 nm 在 181°C 接面溫度(遠高於機櫃內實際的 Tj ~130°C)下完全無傷。這就是為什麼 Lumentum 把 1060 nm 當成 scale-up 的答案,而它第一代的規格是:64 Gb/s NRZ × 256 通道 = 8 Tb/s、2.0 mm 岸線、2.5 pJ/bit。
1. 第一代的規格:8 Tb/s 塞進 2 毫米岸線
先把目標講清楚。這場談的是 scale-up——同一個機櫃或相鄰機櫃內把 GPU 連起來,最長大約 30 公尺,實際多半更短。
講者用一張橫軸是互連距離、縱軸是「頻寬密度 × 能效(Gbps/mm ÷ pJ/bit)」的優值圖來定位。圖上分成三個區間:封裝內(In-Package)、板上(On Board)、板外(Off Board),然後畫了四條線:
電氣互連:一路往下掉,到了一公尺以外就沒有競爭力
State-of-Art Optical:比電氣平坦,但在 10 公尺以上開始不夠
傳統光收發器:整條線趴在底部
VCSEL/PD 陣列:一條幾乎水平的線,在 10–100 公尺區間比傳統光收發器高 2000 倍、比 state-of-art optical 高 20 倍
而右下角那個「第一代」標註寫得很具體:
VCSEL/PD 陣列第一代:64 Gb/s NRZ per VCSEL × 256 通道(8 Tb/s)、2.0 mm 岸線、2.5 pJ/bit
把這組數字算一下就知道它的位置:8 Tb/s ÷ 2.0 mm = 4 Tb/s/mm 的岸線密度。 對照 NVIDIA 微環測試晶片的 0.8 Tb/s/mm、Huawei 給 1024-lane 交換機訂的 0.3 T/mm——VCSEL 陣列在岸線密度這一欄是領先的,而它只用 NRZ。
而 2.5 pJ/bit 這個數字也要放對位置:這是含 VCSEL 的鏈路數字,比同一屆 Aperion 的 1.5 pJ/bit 高,但遠低於矽光子 CPO 喊的 <5 pJ/bit。
講者也承認了 VCSEL 路線最大的爭議:成本。 因為每通道速率低,同樣的總頻寬需要多很多條光纖。他的說法很務實:「取決於距離與需要幾條光纖,這可能是個問題——但我們認為對 scale-up 是可以接受的。」
這句話值得記住,因為它正好是 NVIDIA 在同一天的回顧演講中,讓他們暫停 slow-and-wide 專案的同一個理由。 那場的完整脈絡我們整理在 銅纜撐不住 AI 之後:scale-up 光互連的七條路,與各撞一堵牆的兩種活法。
2. 為什麼是背面發射加覆晶:熱阻直接降四成
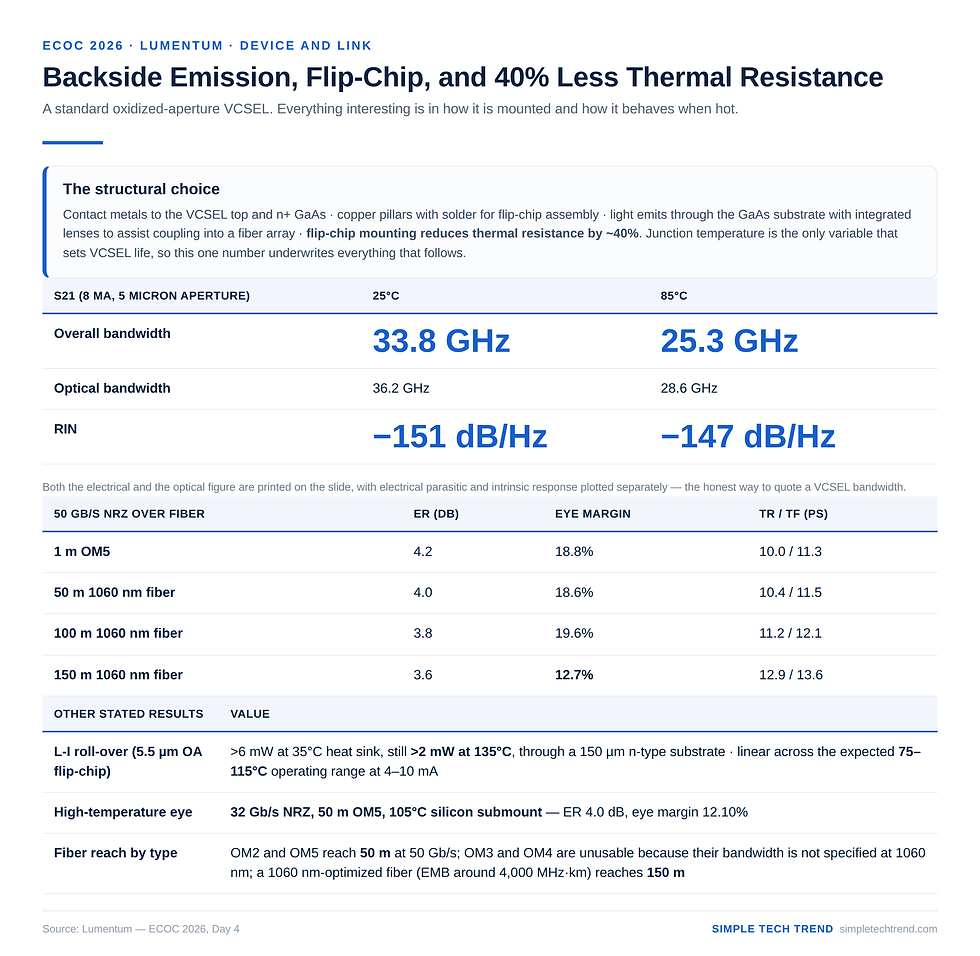
元件結構本身沒有任何花招——標準 VCSEL 結構、氧化孔徑。真正的設計選擇在封裝方式:
接觸金屬接到 VCSEL 頂部與 n+ GaAs
銅柱加錫,做覆晶組裝
光從 GaAs 基板背面射出,基板上有整合透鏡協助耦合到光纖陣列
而那句關鍵的結論是:覆晶 VCSEL 把熱阻降低了約 40%。
這一條是整場演講的物理基礎。 背面發射(Back Side Emitting,BSE)加覆晶,等於把發熱的主動區直接貼在散熱的次載板上,而不是隔著整顆晶片。熱阻降四成,代表同樣的偏壓電流下接面溫度低很多——而接面溫度正是決定 VCSEL 壽命的唯一變數。
LI 曲線印證了這件事。一顆 5.5 µm 孔徑的覆晶 1060 nm VCSEL,在散熱片溫度 35°C 到 135°C 的八條曲線上:
35°C 時輸出功率超過 6 mW
135°C 時仍有超過 2 mW 的峰值
投影片註明:功率與翻轉點都比同樣孔徑尺寸的頂部發射 VCSEL 高很多,原因就是(頂部發射的)熱傳導較差
在預期的 75–115°C 操作範圍內非常線性,視資料速率在 4 到 10 mA 之間
而且這是穿過 150 µm 的 n 型基板之後的功率——講者的評語是「即使穿過基板,功率也綽綽有餘」。
3. 效能數字:33.8 GHz、−151 dB/Hz,而 85°C 只掉 8 GHz
S21 的量測給了四個數字,而且 25°C 與 85°C 兩組都有:
25°C:整體頻寬 33.8 GHz;光學頻寬 36.2 GHz;RIN −151 dB/Hz
85°C:整體頻寬 25.3 GHz;光學頻寬 28.6 GHz;RIN −147 dB/Hz
(8 mA 偏壓,孔徑約 5 µm)
這裡有兩件事值得注意。
第一,投影片同時給了「整體頻寬」與「光學頻寬」兩個數字,而且把電氣寄生與本質響應分開畫。 這正好是同一屆 NVIDIA 回顧演講點名的那個 10log/20log 陷阱——Lumentum 這邊把兩個口徑都標出來了,這是誠實的做法。
第二,從 25°C 到 85°C 只掉了 8.5 GHz。 對照商用 200G VCSEL 的整體現況——多數 850 nm 元件在 75°C 就掉到 35 GHz 上下——這個溫度穩定性才是 1060 nm 的真正賣點。
RIN 也很關鍵。−151 dB/Hz 在 25°C、85°C 仍有 −147 dB/Hz,而講者特別提到這顆元件的 S21 有一點過衝(overshoot),「不太適合 PAM-4,是為 NRZ 做的」。這是一個明確的路線選擇:不拼調變格式,拼通道數。
4. 實際跑起來:50G 到 150 公尺,105°C 下 32G
NRZ 的實測結果分兩組。
距離這一組(50 Gb/s NRZ):
1 m OM5:ER (dB) 4.2;眼圖餘裕 18.8%;上升/下降時間 10.0 / 11.3 ps
50 m 1060nm 光纖:ER (dB) 4.0;眼圖餘裕 18.6%;上升/下降時間 10.4 / 11.5 ps
100 m 1060nm 光纖:ER (dB) 3.8;眼圖餘裕 19.6%;上升/下降時間 11.2 / 12.1 ps
150 m 1060nm 光纖:ER (dB) 3.6;眼圖餘裕 12.7%;上升/下降時間 12.9 / 13.6 ps
投影片的結論句有三行:預期第一個實作會用 NRZ;1060 nm VCSEL 已展示 50 Gb/s NRZ 用 OM2 與 OM5 跑到 50 公尺,用 1060 nm 優化光纖跑到 150 公尺;覆晶 1060 nm VCSEL 已展示 105°C 下的 32 Gb/s。
那個 105°C 的高溫眼圖要單獨拿出來看:32 Gb/s NRZ、50 m OM5、矽次載板 105°C,ER 4.0 dB、眼圖餘裕 12.10%。這代表的是次載板 105°C,而主動區更熱——這個溫度已經超過多數 850 nm 元件的量測條件。
關於那條「1060 nm 優化光纖」,問答時有人追問是不是還是多模光纖。講者的回答是:基本上就是一般的 OM 光纖,只是改了摻雜方式把最小色散點移到 1060 nm,EMB 大約落在 4,000(MHz·km)的等級——「比 OM5 在 850 nm 還好」。 但他也承認:這仍然是一條新光纖。
而 OM3 與 OM4 他直接排除了——因為它們的頻寬在 1060 nm 根本沒有被規範。能用的只有 OM2(原本為 850 與 1300 nm 優化)與 OM5,而且只到 50 公尺。
這一段跟同一屆 NVIDIA 提案 26/80 新光纖是同一個故事:1060 nm 的元件已經準備好了,光纖還沒有。 光源與封裝端的產能瓶頸我們整理在 ECOC2026 | 資料中心要幾十億顆雷射,卡住的卻是「接上去」那 5 分鐘。
還有一段對系統商很有用:有客戶要求把 pJ/bit 再往下壓。 而講者給的物理直覺是:把電流調低,功耗大致以電流平方下降,但頻寬只以略低於線性的速率下降——所以優值會改善。 投影片上那張低功耗眼圖表格證明了這件事:在 2.5 到 4.0 mA 的偏壓範圍內,1 m 與 30 m OM2、25 與 32 Gb/s、25°C 與 85°C,眼圖都還開著。
5. 那張可靠度圖:這才是整場的結論
這是我認為整個 ECOC 2026 上最有說服力的單一張投影片,因為它是一個條件完全對齊的對照實驗。
兩組的條件:
燒機:1060 nm(~5 µm 孔徑) 90°C、9 mA;850 nm(~5 µm 孔徑) 90°C、9 mA
加速條件:1060 nm(~5 µm 孔徑) 8 mA、115°C 烤箱;850 nm(~5 µm 孔徑) 8 mA、115°C 烤箱
接面溫度:1060 nm(~5 µm 孔徑) Tj 181°C;850 nm(~5 µm 孔徑) Tj 183°C
樣本數:1060 nm(~5 µm 孔徑) 86 顆;850 nm(~5 µm 孔徑) 22 顆
結果:
1060 nm:跑到 5,000 小時,沒有任何失效、漂移極小,而且這個 cell 還在跑。臨界電流漂移、功率漂移、電壓漂移三張圖全部是平的。
850 nm:600 小時之後開始觀察到功率與臨界電流漂移,1,600 小時之後出現災難性失效。 那幾條曲線在 2,000 到 3,000 小時之間直接斷掉。
而投影片對 850 nm 那組加了一行極重要的註解:這片晶圓是通過「8 mA、85°C、20 年、100G」規格要求的。
把這件事翻成白話:一顆完全合格、可以出貨的 850 nm 元件,放進 scale-up 機櫃的熱環境裡,會在不到兩千小時內壞掉。 這不是良率問題,是材料問題。
講者在問答時解釋了物理原因,三個層次:
1. 摻雜與增益: 850 nm 為了拉高增益必須在量子井裡放很多銦,而 1060 nm 本來就有更高的銦含量,這讓它更穩健、也更有效率。
2. 載子密度: 1060 nm 增益更高,所以可以在更低的載子密度下操作——而載子密度正是造成磨耗的主因。
3. 光子能量: 850 nm 的光子能量更高,足以讓結構裡既有的缺陷長大;1060 nm 的光子能量低很多,不太可能推動這件事。 他還補了一句對照:1550 nm 的光子能量太低,所以根本看不到這個失效模式。
而最後那個數字才是決勝點:投影片寫明 Tj 181°C 遠高於 scale-up 機櫃內的最高操作溫度 Tj ~130°C。
也就是說,1060 nm 在一個比實際使用嚴苛得多的條件下跑了 5,000 小時無傷。 講者引用的推算是:在低應力條件下,模型算出來是十萬年等級的平均失效間隔。
6. 嬰兒期失效:七萬兩千顆發射器,28 DPPM
磨耗解決了,接下來是早夭。而這一段展現的是 Lumentum 真正的護城河——他們有 3D sensing 的量產測試基礎設施。
頂部發射 1060 nm 陣列的測試規模:
5 片晶圓 × 180 顆元件 × 80 個發射器 = 900 顆元件、72,000 個發射器
應力條件:9.0 mA/發射器、CW、80°C
讀點條件:9.0 mA/發射器、1.0 ms、10% 工作週期、25°C
良品判定:發射器功率 3 到 10 mW
T = 0 hr:發射器失效數 1(組裝損傷);DPPM 14
T = 24 hr:發射器失效數 2(新增一顆磊晶缺陷);DPPM 28
T = 96 hr:發射器失效數 2;DPPM 28
七萬兩千個發射器,跑完 96 小時應力只有兩顆失效,而其中一顆是組裝造成的。
底部發射(覆晶)那組還在早期: 1 片晶圓、108 顆元件、8,640 個發射器,T=0 時 1 顆失效(116 DPPM),T=100 小時 2 顆(231 DPPM),而且兩顆都是組裝過程中損傷的。投影片誠實地標註:覆晶組裝製程仍在開發中,更多晶圓資料預計年底出來。
而整個可靠度論證的終點寫在同一張投影片上:
目標是 <50 DPPM,包含早夭、隨機、磨耗、環境與機械所有失效模式。
講者接著補了系統層的換算:達到這個目標之後,只要加上少量的備援通道,每條鏈路就能做到低於 10 FIT,甚至低於 1 FIT。
這個「用備援換可靠度」的思路,跟同一屆 Microsoft 講慢而寬時的論證完全一致——通道多的時候,多放幾條的邊際成本接近零,所以可靠度是用架構做出來的,不是靠把單一元件做到極致。
7. 製造:踩在已經出貨幾十億顆的那條產線上
最後一段是這條路線最難被複製的地方,而它跟光通訊沒什麼關係——它跟 iPhone 的臉部辨識有關係。
投影片列得很清楚:
基於 6 吋 GaAs,而且特別註明一句:避開 InP 的供應問題
沿用 3D 感測(3DS)VCSEL 的供應鏈:已出貨數十億顆 3DS VCSEL 陣列,對波長、光功率、臨界電流、光束均勻度、可靠度與成本都有很緊的控制
磊晶成長製程與設計是從 940 nm 的 3DS 改過來的,針對 1060 nm 與高速做調整
晶圓製程與設備跟既有 3DS 產品相同或非常相似,包含背面發射製程
品質控管計畫也沿用:磊晶成長、晶圓廠量測、目視檢查、元件測試
問答時有人問良率與單片產出。講者的回答是:最大的 3D 感測晶粒,一片 6 吋晶圓大約出一萬顆;1060 nm 的晶粒比較小,可能是三萬到四萬顆,而每顆晶粒上有 50 到 100 個發射器。 投影片上那張 6 吋晶圓圖標註的是 ~1 mm² 的晶粒。
至於元件設計本身,投影片給了一個很有彈性的訊號:80 個發射器的六角形陣列可以對到客製光纖束、也可以對到光纖盤或不同間距的多芯光纖,而且已經做出了覆晶到矽扇出板、帶透鏡的實體。
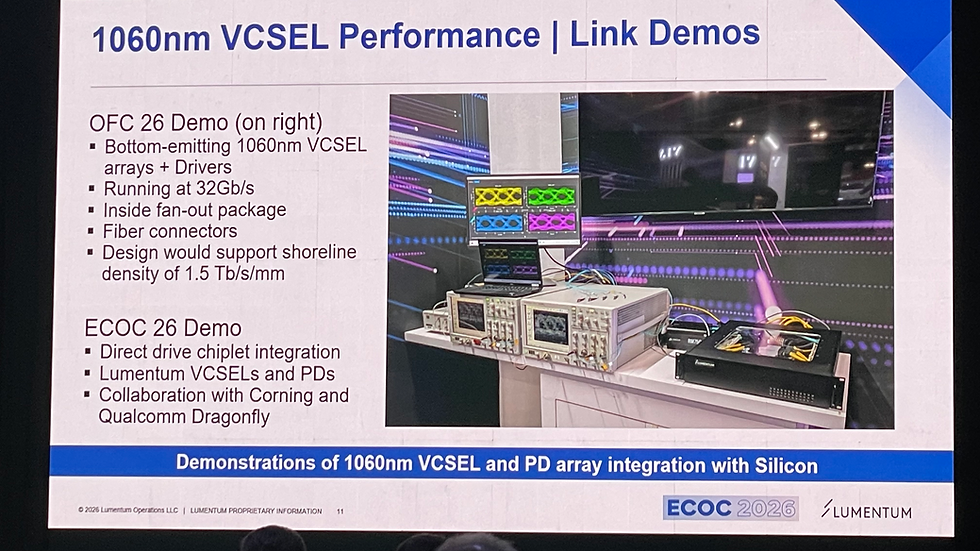
而 demo 的部分透露了兩個合作對象:
OFC 2026 demo:底部發射 1060 nm VCSEL 陣列加驅動器,32 Gb/s,在扇出封裝裡,帶光纖連接器——這個設計可支援 1.5 Tb/s/mm 的岸線密度
ECOC 2026 demo:直接驅動的 chiplet 整合,Lumentum 的 VCSEL 與 PD,與 Corning 及 Qualcomm Dragonfly 合作
Qualcomm 這個名字出現在這裡,是這場演講裡最容易被漏掉、但訊息量最大的一件事。 它說明 1060 nm VCSEL 的 chiplet 整合已經有非 GPU 大廠在後面推。
8. 總結
把這場放進 ECOC 2026 的脈絡,它跟同一天 NVIDIA 那場回顧演講形成了一組完整的敘事:NVIDIA 說 VCSEL 的功耗問題早就解決、卡住的是光纖;Lumentum 這場則是把「可靠度」這個最後的疑問也一併回答掉。
對台灣供應鏈,三個具體落點:
第一,那張 850 vs 1060 的對照圖應該成為評估任何 VCSEL 方案的標準問句。 不要再問「這顆元件的頻寬是多少」,要問的是「它在 Tj 180°C 跑得了幾小時」。因為 850 nm 有一片通過 20 年規格的晶圓,在同樣條件下 1,600 小時就掛了——規格書上的 20 年,是在 85°C 算出來的,而 scale-up 機櫃不是那個環境。
第二,1060 nm 的真正壁壘不在元件,在那條 3D sensing 產線。 6 吋 GaAs、940 nm 磊晶改 1060 nm、幾十億顆的量產統計、以及能一次測七萬兩千個發射器的測試方法——這些都不是新進者能在兩年內建起來的。 對台廠而言,機會不在跟 Lumentum 拼 VCSEL,而在它需要但自己不做的那些東西:光纖束、光纖盤、矽扇出次載板、透鏡陣列、以及覆晶組裝——注意,它自己承認覆晶組裝製程「仍在開發中」,而目前的失效幾乎全部來自組裝。
第三,光纖仍然是那個沒解決的變數。 OM3 與 OM4 在 1060 nm 不可用、OM2 與 OM5 只到 50 公尺、能跑 150 公尺的是一條「概念上是簡單改動、實際上是新品」的客製光纖。而同一屆 NVIDIA 正在提案 26/80 的新規格。 誰先把 1060 nm 的多模光纖做成標準品,誰就拿到這一輪的定價權。
宣判:這場演講最有價值的不是 8 Tb/s、也不是 2.5 pJ/bit,是那張把 850 nm 與 1060 nm 放在同一個烤箱裡的對照圖。它證明了一件事:VCSEL 在 scale-up 的瓶頸從來不是速度,是熱——而 1060 nm 解決的正是熱。當一顆通過 20 年規格的 850 nm 元件在 1,600 小時內壞掉,而 1060 nm 在更高的接面溫度下跑完 5,000 小時毫髮無傷,波長的選擇就不再是偏好問題,是可行性問題。
本文僅供技術與產業趨勢分析,不構成任何投資建議。
相關閱讀
銅纜撐不住 AI 之後:scale-up 光互連的七條路,與各撞一堵牆的兩種活法:VCSEL 陣列在七大 scale-up 方案裡的位置,以及「多很多條光纖」這個代價的完整帳
ECOC2026 | 資料中心要幾十億顆雷射,卡住的卻是「接上去」那 5 分鐘:同一屆光源 workshop 的封裝與對準瓶頸,與本文的覆晶組裝失效互為印證
ECOC2026 | 快窄與慢寬吵了三小時,沒有人先定義「慢」:這場辯論真正的分水嶺是 448G:為什麼 Lumentum 選擇「不拼調變格式、拼通道數」的路線


留言