


ECOC2026 | 技術文章分析 | NVIDIA 把九顆微環對準九條雷射:2.78 pJ/b 的 DWDM 光鏈路,難的不是速度,是「開機」
NVIDIA 在 ECOC 2026 發表的這篇論文,解的不是一個速度問題,是一個開機問題。他們今年稍早在 ISSCC 與 OFC 發表過一顆微環 DWDM 測試晶片——每纖 256 Gb/s、2.78 pJ/b、0.8 Tb/s/mm 的岸線密度,數字很漂亮。但那張漂亮的眼圖背後,是九顆 TX 微環與九顆 RX 微環要各自對準九條雷射,而且晶片看不到光譜、不知道雷射在哪、也不知道自己的絕對波長。在實驗室可以手動調,在商品裡不行。這篇論文給的就是自動化解法:靜態環分配(SRA) 在開機時找出總加熱功率最低的一組環-雷射映射;動態環分配(DRA) 則在晶片溫度漂移時一邊跑資料、一邊把整組映射旋轉過去——包括在不掉任何一個位元的前提下,把前向時脈從一條通道換到另一條通道。
1. 論文背景:這是誰發表的、為什麼值得看
發表單位:NVIDIA Corporation(Santa Clara、Durham、Ridgefield 三地團隊)
會議:2026 European Conference on Optical Communication(ECOC 2026),2026 年 9 月 22 日
主講:Angad S. Rekhi
共同作者:Stephen G. Tell、Brian Zimmer、Li Xu、Georgios Kalogerakis、Sanquan Song、Nandish Mehta、Nikola Nedovic、Yoshi Nishi、Xi Chen、Ward Lopes、Benjamin G. Lee、Thomas H. Greer III、C. Thomas Gray
為什麼值得看?因為這不是又一篇「我們做了一個更快的光鏈路」的論文。它是一篇把光學元件的物理特性,交給數位控制迴路去馴服的論文——而那正是微環 DWDM 從論文走向產品的那道門檻。
微環(microring)的好處是體積小、可以在同一條匯流排上串很多顆,所以它是把岸線密度推上去的最直接路徑。它的壞處也很單純:微環的共振波長對溫度極度敏感,晶片溫度變幾度,共振就跑掉了。要讓它穩定工作,每一顆環都需要一個加熱器與一個閉迴路。
當你只有一顆環,這是控制問題。當你有十八顆環(TX 九顆、RX 九顆)要各自鎖到九條雷射上,這就變成了一個組合最佳化問題。

2. 為什麼要做光在中介層上:100 mm 縮成 8 mm
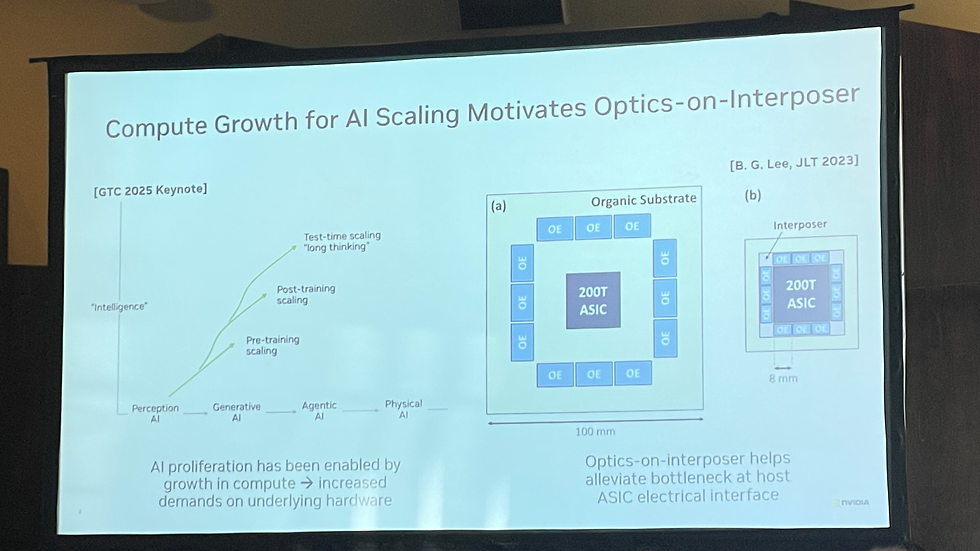
第一張內容投影片把動機講得很直接,而且用了一組很有畫面的對比。
這張圖展示了:左半部是 GTC 2025 主題演講那張「智慧成長」曲線——感知 AI → 生成式 AI → 代理型 AI → 實體 AI,疊上預訓練擴展、後訓練擴展、測試時擴展(「長思考」)三條加速曲線。右半部則是引自 B. G. Lee 在 JLT 2023 的一張架構對照。
關鍵數字/發現:右半部的 (a) 與 (b) 才是重點。同樣一顆 200T 的 ASIC:
(a) 放在有機基板上,光引擎(OE)排在 ASIC 四周,整塊基板寬 100 mm
(b) 放在中介層(interposer)上,光引擎直接圍在 ASIC 旁邊,距離只有 8 mm
對產業的意義:從 100 mm 到 8 mm,不是「比較好」,是兩個量級的電走線距離差異。而電走線的長度直接決定了你需要多強的 SerDes、多大的 DSP、多少的功耗。這就是「光在中介層上」(optics-on-interposer)這個概念的全部論證——把主機 ASIC 電介面那個瓶頸直接繞過去。
這條路線的另一半——雷射陣列——我們在 ECTC 2026 | NVIDIA | 光不應該被強制轉成電再轉回光:NVIDIA 的 DWDM 雷射陣列為何改寫光互連的經濟學 拆過。
3. 測試晶片:2.78 pJ/b 與 0.8 Tb/s/mm 是怎麼來的
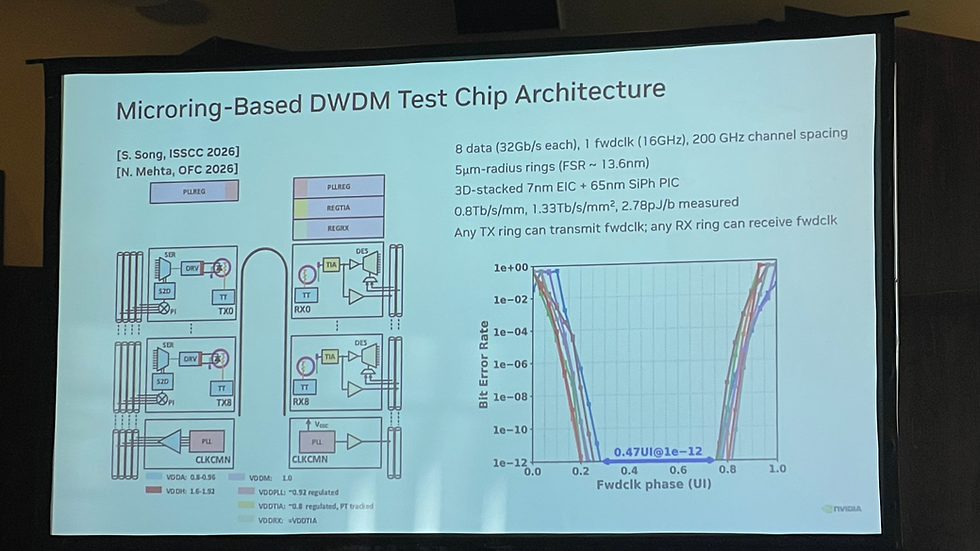
這張圖展示了:這顆測試晶片的完整架構與規格,引用自 S. Song(ISSCC 2026)與 N. Mehta(OFC 2026)兩篇論文。左邊是電路方塊圖(TX0…TX8、RX0…RX8、CLKCMN 時脈共用區塊),右邊是 BER vs 前向時脈相位的浴缸曲線。
關鍵數字/發現:
8 條資料通道,每條 32 Gb/s;1 條前向時脈(fwdclk),16 GHz——也就是半速率時脈
200 GHz 通道間距
5 µm 半徑的微環,FSR 約 13.6 nm
3D 堆疊:7 nm EIC + 65 nm 矽光子 PIC
實測 0.8 Tb/s/mm、1.33 Tb/s/mm²、2.78 pJ/b
任何一條 TX 通道都能發送前向時脈;任何一條 RX 通道都能接收它
浴缸曲線:在 1e-12 的錯誤率下有 0.47 UI 的開眼
8 × 32 Gb/s = 每條光纖 256 Gb/s。
對產業的意義:三件事。第一,0.8 Tb/s/mm 這個岸線密度,正好落在同一屆 Huawei 說「1024-lane 交換機需要超過 0.3 T/mm」的目標之上——微環 DWDM 確實是能把密度推上去的路。第二,2.78 pJ/b 已經低於 3,而這個數字是含時脈的完整鏈路。第三,也是最容易被略過的——「任何一條通道都能收發時脈」這個設計選擇,不是彈性,是整篇論文後半段的前提。

4. 核心問題:晶片是瞎的
這張圖展示了:靜態環分配(SRA)的問題定義。左邊是一張直通埠(through port)的光譜圖,橫軸波長 1290–1310 nm,縱軸直通功率 dBm;虛線是九條雷射的波長 λ0(最紅)到 λ8(最藍),綠色箭頭是每顆環需要被加熱移動的量。右上角是一張「輪盤圖」,外圈是環的共振位置、內圈是雷射波長。
關鍵數字/發現:講者強調了一句很重要的話——這張光譜只是為了簡報說明,晶片本身沒有能力直接觀察光譜。
問題的完整敘述是:在既拿不到雷射、也拿不到光纖連接、更不知道絕對波長的情況下,只用晶片上的資源,找出「環 → 雷射」的功率最佳映射。
而約束條件有兩個:
光譜順序必須等於空間順序(環在匯流排上的排列順序),因為這能降低串擾
但允許整體繞著 FSR 旋轉一圈——這正是省電的關鍵
對產業的意義:第二個約束是這篇論文最聪明的地方。環的柵格(ring grid)與雷射柵格(laser grid)之間一定有製程偏移,如果強制「第 0 顆環必須配第 0 條雷射」,某些環就得被加熱很多才能到位。但如果允許整組映射旋轉——例如環 4 配 λ0、環 5 配 λ1、……環 0 配 λ5——總加熱功率就可能大幅下降。
輪盤圖的設計本身也值得學:外圈是連續的(因為環的共振每隔一個 FSR 就重複一次),內圈是斷開的(因為雷射波長沒有這種週期性)。逆時針是往紅走,順時針是往藍走。

5. 晶片能看到的只有兩個數字:ADC code 與 DAC code
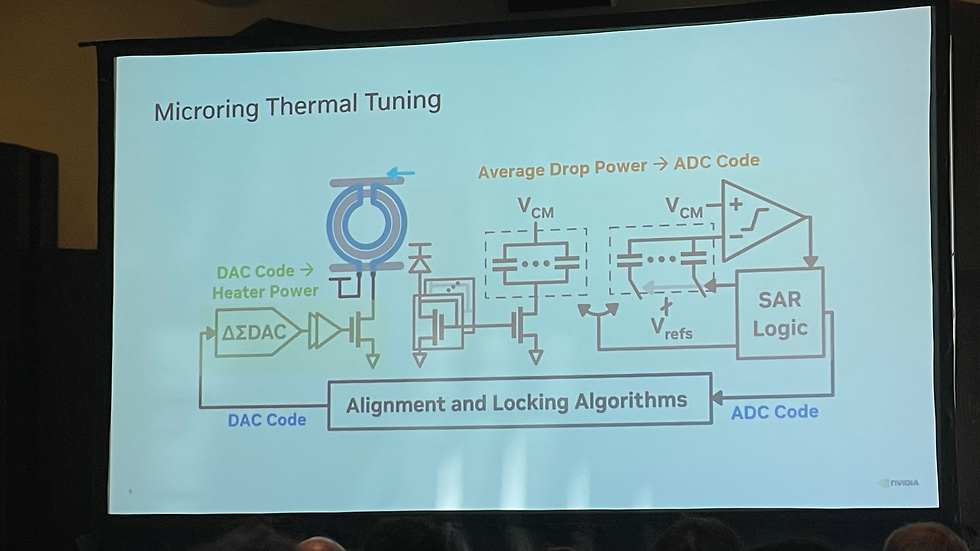
這張圖展示了:微環熱調諧的完整迴路。左邊是環與它的加熱器,由一顆 ΔΣ DAC 驅動;右邊是把掉落埠(drop port)的平均光功率經過 SAR 邏輯數位化成 ADC code;中間下方是「對準與鎖定演算法」方塊。
關鍵數字/發現:整篇論文只需要記兩個對應關係:
ADC code ≈ 掉落埠的平均光功率(晶片的「眼睛」)
DAC code ≈ 加熱器功率(晶片的「手」)
對產業的意義:這張圖是整個設計哲學的縮影。晶片沒有光譜儀,只有一顆 ADC 和一顆 DAC。 所有的智慧都必須從「掃一遍 DAC code、看 ADC code 怎麼變」這一件事裡長出來。這也是為什麼這套方法能被做進商品——它不需要任何外部量測設備。
6. SRA 的 TX 側:從一次掃描,到一條極簡規則
這幾張圖展示了:TX 匯流排的靜態分配流程,逐環進行。橫軸是 DAC code 0 到 8192,縱軸是 ADC code。
第一步,把匯流排上的第一顆環 TX0 從熱掃到冷(DAC code 從高到低),記錄掉落埠功率。雷射會以峰值的形式出現在掃描曲線上。 這裡有一個很誠實的觀察:如果沒有自加熱效應,峰形應該是漂亮的洛倫茲線型;但實際掃出來是尖銳的三角形——這代表自加熱在這顆晶片上是顯著的。
第二步,挑一條雷射鎖上去。範例中選的是「加熱功率第二高」的那條(λ2)。鎖的方式是:先把環加熱到超過那條雷射,讓它進到正確的遲滯狀態,再回鎖到量到的峰值掉落功率約 75% 的那個點——那是 OMA 最佳化的位置。
第三步,對每一顆後續的環重複掃描,並用峰值突出度(peak prominence) 來分辨「已被上游環佔用的雷射」與「還沒被佔用的雷射」。例如 TX1 掃到 λ2 時,功率明顯低於它看到的其他雷射,因為 λ2 已經被上游的 TX0 鎖走了——這就叫被捕獲的雷射(captured laser)。
然後是那條極簡的規則:
正在被分配的目標環,應該鎖到它在「最後一條被捕獲的雷射」之後看到的「第一條未被捕獲的雷射」。
從熱掃到冷的方向下,這條規則會自動保證:目標環鎖到最紅的那條未被捕獲雷射,而且光譜順序會等於空間順序,容許一次繞 FSR 的旋轉。如果一顆環完全沒看到被捕獲的雷射,它就鎖到加熱功率最高的那條。
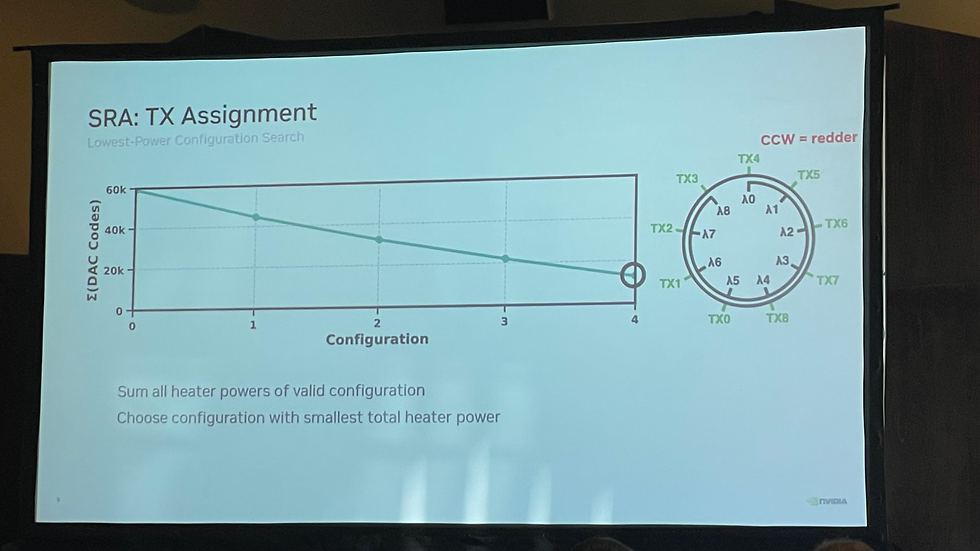
第四步,把所有環都分配完的組態稱為有效組態,加總它的總加熱功率;然後把 TX0 改鎖到「加熱功率次低」的那條雷射,重跑一次;如此列舉。總加熱功率最低的那組,就是最終選擇。
對產業的意義:這套流程的美感在於它把一個全域最佳化問題,化約成一條逐環執行的局部規則加上有限次的窮舉。而且已分配的環在整個過程中都保持閉迴路鎖定,不會被後續動作影響。講者也誠實提到還有更多邊角情況(例如一顆環看到兩組連續的被捕獲雷射),那些留在論文裡。


7. SRA 的 RX 側:被捕獲的雷射會「消失」
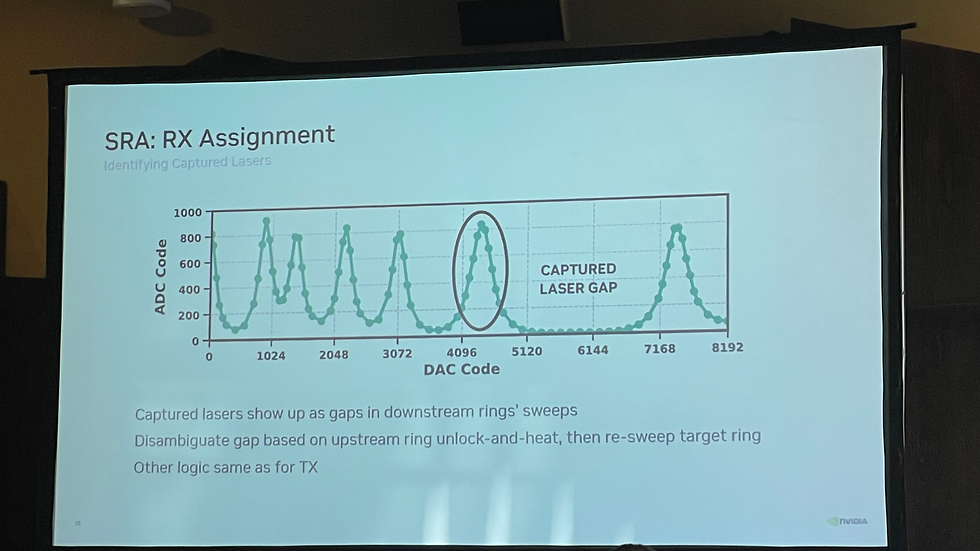
這張圖展示了:RX 匯流排分配時的掃描曲線,橫軸同樣是 DAC code 0 到 8192,縱軸 ADC code 0 到 1000。圖上圈出了一段被標為 CAPTURED LASER GAP(被捕獲雷射的間隙) 的區域。
關鍵數字/發現:RX 側有一個 TX 側沒有的麻煩。因為 RX 環是鎖在共振上(on resonance),而不是像 TX 環那樣鎖在偏離共振的位置,所以被上游 RX 環捕獲的雷射,在下游環的加熱掃描裡根本不會出現——不是變弱,是完全消失。
於是判斷邏輯必須反過來:去找「未被捕獲雷射之間的間隙」,把間隙當成被捕獲雷射存在的證據。
但間隙有三種可能來源:真的有雷射被捕獲、環的光譜裡剛好有一個 FSR 間隙、或者雷射本身的線間距有變異。怎麼分辨?論文給的方法很直接:
把緊鄰的上游環解鎖、加熱一點點,然後重掃一次目標環。如果有一條新的雷射冒出來,這個間隙就是「捕獲間隙」。 確認後把上游環重新正確鎖回去,再把目標環鎖到「相對於捕獲間隙、DAC code 稍低」的那條雷射上。
對產業的意義:這個「解鎖上游、加熱、重掃」的手法不只用在 RX。講者補了一句很實用的話——如果雷射功率不夠均勻,導致 TX 側單純的功率門檻也無法分辨被捕獲與未被捕獲,TX 側也可以用同一套程序。 換句話說,這是一個對雷射功率不均具備韌性的設計。
8. DRA:讓映射在跑資料的時候旋轉
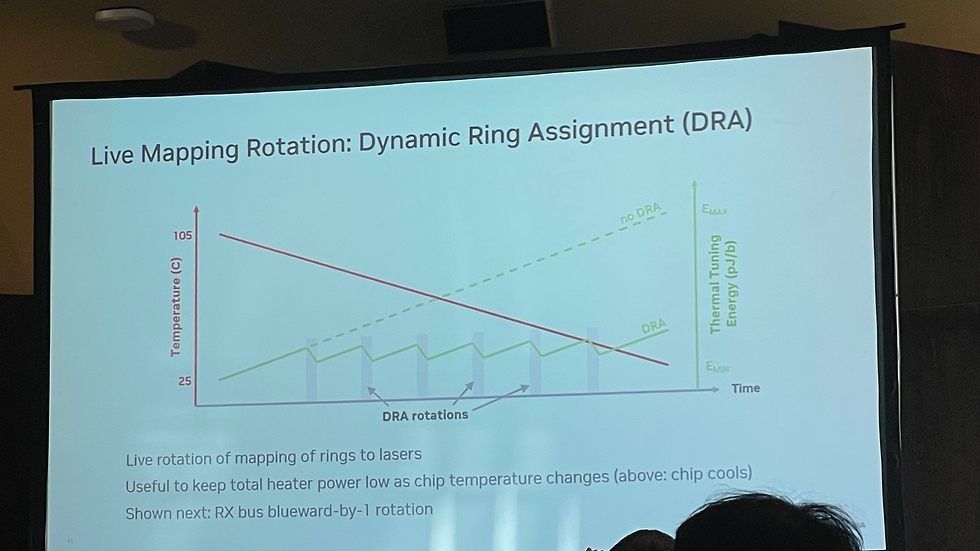
這張圖展示了:動態環分配(DRA)的動機。橫軸是時間,左縱軸是晶片溫度(從 105°C 降到 25°C),右縱軸是熱調諧能耗(pJ/b)。紅線是溫度、綠線是熱調諧能耗——虛線是「不做 DRA」的情況,實線是「做 DRA」的情況,實線呈現鋸齒狀,每一個下跌都標著「DRA rotation」。
關鍵數字/發現:晶片從 105°C 冷卻到 25°C,這是一個 80°C 的溫度範圍。在沒有 DRA 的情況下,要維持所有環的共振位置不變,就得持續加熱補償,熱調諧能耗單調上升。但如果允許「環 → 雷射」的映射活著旋轉,總加熱功率就能在整個溫度範圍內都維持在相對低的水準。
對產業的意義:這一點對做 CPO/光引擎的人特別重要。微環 DWDM 最常被質疑的就是熱調諧功耗——你省下了 DSP 的功耗,卻把它花在加熱器上,那到底有沒有賣?這張圖給的答案是:如果你的控制邏輯夠聪明,熱調諧功耗不需要隨溫度漂移單調增加。 這把「微環不實用」這個質疑,從物理問題降級成了控制問題。
9. 旋轉的代價,與那個沒有代價的時脈交換
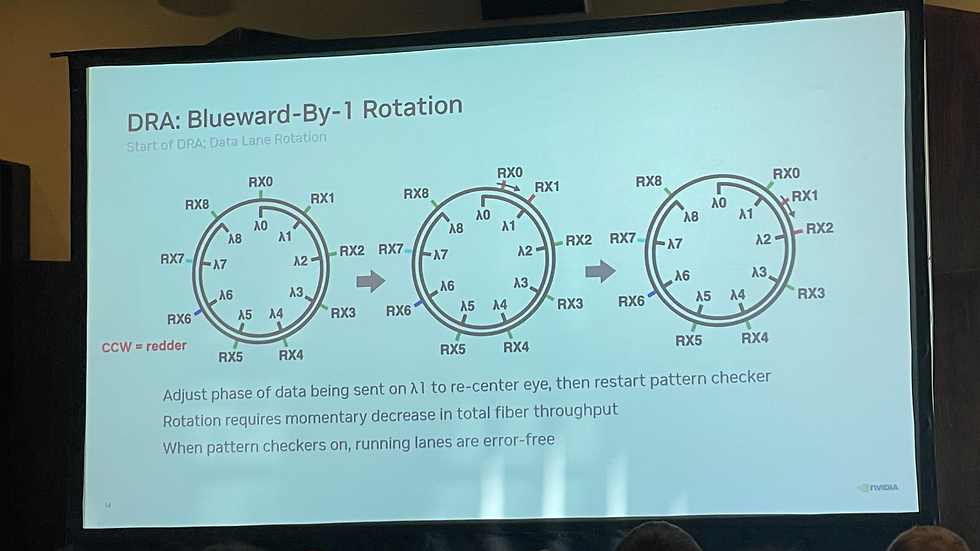
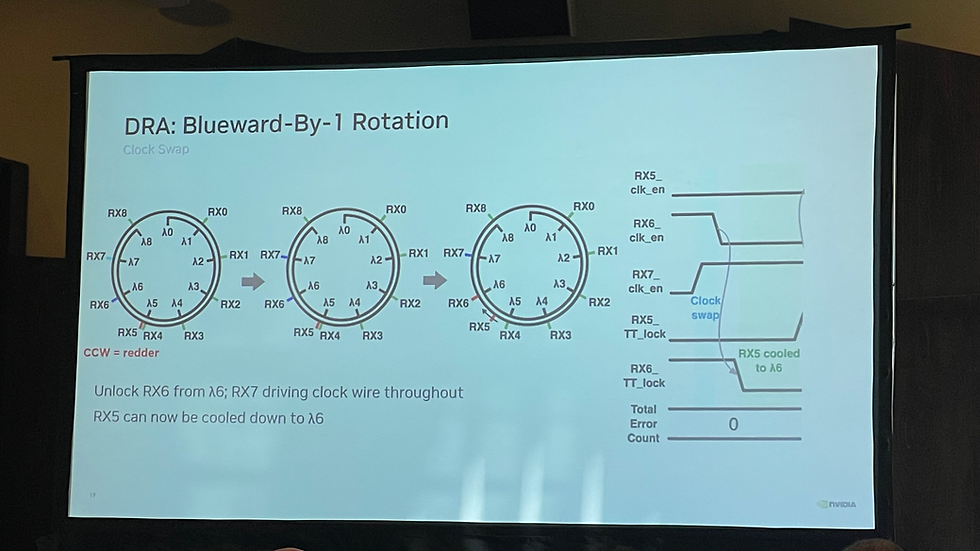
這幾張圖展示了:RX 匯流排「往藍旋轉一格」(blueward-by-1 rotation)的完整過程,用一連串輪盤圖呈現,最後幾張搭配時序圖。綠色代表該通道在收資料、藍色代表在收時脈、紅色代表該通道的圖樣檢查器(pattern checker)已停止。深藍色表示收到的時脈正在驅動用來取樣資料的時脈線,淺藍色表示還沒驅動任何東西。
資料通道的旋轉很單純:停掉兩條通道的圖樣檢查器、解鎖兩顆環、凍結加熱器碼;把 RX0 往順時針(往藍)移到 λ1 鎖住;調整該波長上送出資料的相位讓眼圖重新置中,再重啟圖樣檢查器。投影片上寫得很清楚:旋轉需要總光纖吞吐量的短暫下降;但在圖樣檢查器開著的期間,其餘通道是零錯誤的。
時脈通道的交換才是這篇論文真正精彩的地方。 情境是:RX4 剛拿到 λ5、RX5 已解鎖凍結、準備冷卻到 λ6。但要這麼做,就必須先解鎖 RX6——而 RX6 收的正是那條在驅動時脈線的時脈。解鎖它,整條鏈路會直接掛掉。
解法是:第一,先讓 RX7 收到的時脈也開始驅動同一條時脈線。 這段期間,RX6 與 RX7 同時驅動同一條時脈線,而且沒有產生任何位元錯誤。
第二,然後把 RX6 從 λ6 解鎖。 因為 RX7 已經接手驅動時脈線,這個動作同樣沒有位元錯誤。 第三,這就清出了空間,RX5 可以被冷卻到 λ6,旋轉得以繼續。
時序圖右下角那一欄寫著 Total Error Count:0。
講者還補了一句:這個交換不只在「兩條 RX 通道共用同一條時脈線」的情況下成立,他們也驗證過「兩條 RX 時脈通道驅動不同時脈線」的功能性操作,同樣沒有位元錯誤。
對產業的意義:前向時脈架構(clock-forwarding)的省電好處很清楚——接收端不需要 CDR。但它一直有一個結構性的脆弱點:時脈通道是單點故障,而且它不能被動。 這篇論文證明了時脈通道也可以被熱遷移,而且是在鏈路活著、零位元錯誤的狀態下完成。這把前向時脈從「省電但僵硬」變成了「省電而且可調度」。


10. 技術亮點:兩個被解掉的「不可能」
把整篇論文濃縮,真正的創新有兩個,而且都不是元件層級的。
第一,用「允許旋轉」把組合爆炸變成可省電的自由度。 九顆環配九條雷射,如果硬性一對一,那是一個沒有彈性的約束;但允許整組繞 FSR 旋轉,就多出九種等價組態,而它們的總加熱功率可以差很多。論文把一個原本是「限制」的物理現象(FSR 週期性),變成了最佳化的搜尋空間。
第二,前向時脈的熱交換。 這是我認為最該被記住的一段。在一個時脈必須持續有效的系統裡,把時脈的來源從一條通道換到另一條通道,而且不掉位元——這件事在電的世界裡都不算容易,在光的世界裡還要加上熱調諧的遲滯與鎖定時間。他們用「兩條通道短暫同時驅動同一條線」這個看似樸素的手法解掉了。

11. 產業連結:這離量產有多遠
要誠實地說:這是一顆測試晶片,不是產品。 但這篇論文的性質決定了它的位置——它處理的正是「從測試晶片到產品」之間那一段。
講者開場就把這件事講明了:「在實驗室裡量這些浴缸曲線是一回事,但要在商品裡做到,需要一個穩健、自動、可重複的解法。」這三個形容詞就是這篇論文的全部目的。
微環 DWDM 這條路線,現在同時被 NVIDIA、Meta/Broadcom/AMD 的 OCI 陣營在推。OCI 200G 線側規範用的也是微環 DWDM 加外接雷射,我們在 技術文章分析 | Meta、Broadcom、AMD 聯手定義 OCI 200G 線側規範 拆過。而所有走這條路的人,都必須解同一個開機問題。
12. 總結
這篇論文在技術史上的位置,我認為是這樣的:微環 DWDM 過去十年一直被當成「理論上密度最好、實務上太難控」的路線。這篇論文把「太難控」這句話裡的具體內容拆開了,然後一條一條解掉。
對台灣供應鏈,三個具體落點:
第一,0.8 Tb/s/mm 這個數字要記住。 它比同一屆 Huawei 給 1024-lane 交換機設的 0.3 T/mm 目標高了一倍多。微環 DWDM 不是唯一能達標的路,但它是目前把數字攤出來、而且有完整控制方案的那一條。 對做光引擎封裝、做 FAU、做高密度光介面的台廠,這代表微環路線的量產時間表不該被低估。
第二,熱調諧功耗的爭論,答案已經變了。 過去質疑微環的核心論點是「加熱器會把省下來的功耗吃回去」。DRA 那張 105°C 到 25°C 的圖給的回應是:不會,只要控制邏輯允許映射旋轉。 這對評估微環 vs 其他調變器路線(EAM、TFLN、BTO)的人是一個需要重新校準的輸入。
第三,也是最容易被忽略的——這篇論文的價值在「軟體」。 SRA 與 DRA 都是演算法,不是新材料、新製程。這代表這條路線的競爭壁壘,有一部分會落在數位控制迴路的設計能力上,而不只是光學製程。 對台廠而言,這既是壞消息(這不是我們傳統的強項)也是好消息(它不需要新的產線投資)。
宣判:這篇論文最大的貢獻不是那 2.78 pJ/b,是它證明了微環 DWDM 的「不可控」是可以被程式碼解掉的。當九顆環能在一顆瞎眼的晶片上自己找到九條雷射、並且在 80 度的溫度漂移裡一邊跑資料一邊重新洗牌——微環從此不再是一個需要人在旁邊顧的技術。這才是它能不能進商品的分水嶺。
本文僅供技術與產業趨勢分析,不構成任何投資建議。
參考資料
Angad S. Rekhi, Stephen G. Tell, Brian Zimmer, Li Xu, Georgios Kalogerakis, Sanquan Song, Nandish Mehta, Nikola Nedovic, Yoshi Nishi, Xi Chen, Ward Lopes, Benjamin G. Lee, Thomas H. Greer III, C. Thomas Gray, "Static and Dynamic Ring Assignment in a Clock-Forwarded DWDM Optical Link," 2026 European Conference on Optical Communication (ECOC 2026), September 22, 2026. NVIDIA Corporation(Santa Clara, CA/Durham, NC/Ridgefield, CT, USA)
B. G. Lee et al., "Beyond CPO: A Motivation and Approach for Bringing Optics Onto the Silicon Interposer," Journal of Lightwave Technology (JLT), 2023.
S. Song et al., "A 32 Gb/s/λ 256 Gb/s/Fiber Half-Rate Bandpass-Filtered Clock-Forwarding DWDM Optical Link in a 3D-Stacked 7nm EIC/65nm PIC Technology," ISSCC 2026.
N. Mehta et al., "A 256 Gb/s DWDM Optical I/O in a 3D-stacked EIC/PIC Silicon Photonics Platform," OFC 2026.
相關閱讀
ECTC 2026 | NVIDIA | 光不應該被強制轉成電再轉回光:NVIDIA 的 DWDM 雷射陣列為何改寫光互連的經濟學:同一條路線的雷射側,NVIDIA 與 Lumentum 的量產級 DWDM 雷射陣列
技術文章分析 | Meta、Broadcom、AMD 聯手定義 OCI 200G 線側規範:單纖雙向、微環 DWDM、外接雷射的 scale-up 賭注:另一個押注微環 DWDM 的陣營,以及它對外接雷射畫出的規格


留言