


ECOC2026 | 問題不再是「我要幾個波長」,是「我要幾條光纖」:Acacia 把成功的衡量標準從 $/bit 換成 GPU 使用率,然後重排了整張光學技術地圖
Acacia 的 Tom Williams 這場只有十五分鐘,但它是整屆 ECOC 最像「甲方視角」的一場。他講的不是某個元件做到幾 GHz,而是衡量標準換了——投影片上那句話寫得很白:「$/bit 仍然重要,但優化 GPU 使用率才是成功的關鍵指標」。用這把新尺量下去,整張光學技術地圖被重排了一次:CPO、NPO、LPO、LRO、FRO、coherent-lite、ZR/ZR+ 被排成一條從機櫃到都會的階梯,每一階都標上它真正在取捨什麼。而這場最硬的一條物理線是:IMDD 的色散容忍度隨鮑率的平方下降——200G/lane 的極限大約 10 公里,到了 400G/lane,超過 2 公里就必須用 coherent。 加上一句最被低估的觀察:scale-across 的規劃問題已經從「我需要幾個波長」變成「我需要幾條光纖」。
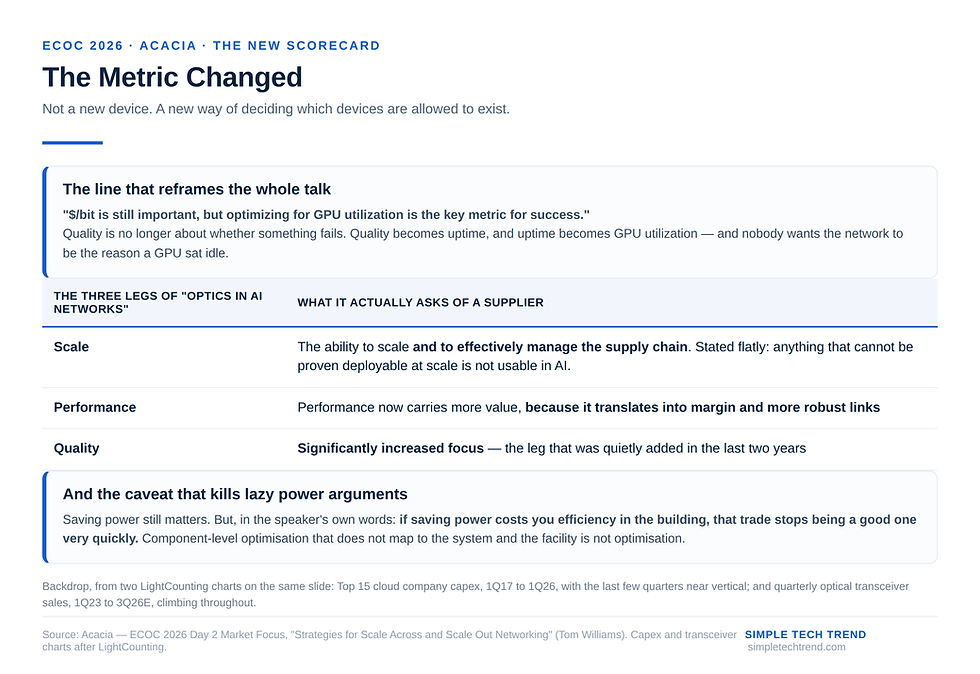
1. 衡量標準換了:$/bit 讓位給 GPU 使用率
過去十年,光模組這個產業的共同語言是 $/bit 與 pJ/bit。Acacia 這場開宗明義地說:這兩個數字當然還重要,但它們已經不是評分表上的第一欄。
投影片底下那句是整場的定調:
$/bit 仍然重要,但優化 GPU 使用率才是成功的關鍵指標。
講者把這件事講得很直白:品質不只是「會不會壞」,品質會轉換成 uptime,而 uptime 最後會轉換成 GPU 使用率。沒有人希望網路是那個讓 GPU 閒置的環節。
而他對「省電」的那段補充特別值得記下來。他不否認省電重要——省一小時網路的價值大家都算得出來——但他接著說:
如果省電的做法讓整棟建築的效率變差,那這個交換很快就不划算了。
這是一句很重的話。它等於在說:元件層的功耗最佳化,如果沒有對到系統層與設施層,就是假的最佳化。 這跟同一屆 Microsoft 在講慢而寬時提出的「四面牆」框架是同一個思路——我們在 銅纜撐不住 AI 之後:scale-up 光互連的七條路,與各撞一堵牆的兩種活法 有完整拆解。
2. 那張三腳凳:規模、效能、品質
投影片上畫了一張三腳凳,凳面寫著「AI 網路裡的光學」,三支腳分別是 Scale(規模)、Performance(效能)、Quality(品質)。
三支腳的定義他寫得很具體:
規模:能不能放大產量,以及能不能有效管理供應鏈
效能:效能的價值更高了,因為它會轉換成裕度(margin)與更穩健的鏈路
品質:對品質的關注度顯著提高
這三件事有一個共同的言下之意:任何新材料、新架構,如果無法證明它能夠以規模部署,那它在 AI 裡就是不可用的。 講者原話是「Anything we do has to be able to be deployed at scale」——這句話是用來篩掉一大票實驗室成果的。
右邊兩張 LightCounting 的圖給了這個論述的背景:Top 15 雲端公司資本支出從 2017 年第一季畫到 2026 年第一季,最後幾根柱子的陡升幾乎是垂直的;下面那張光收發器季銷售額從 2023 年第一季畫到 2026 年第三季預估,同樣是一路往上。
3. Scale-across 為什麼變成 coherent 的主場
Acacia 對 scale-across 的定義很乾淨:地理上分散的資料中心之間的後端(back end)連線。
左邊那張 Meta 的網路流量圖(引自 OFC 2026 Exec Forum)把成長拆成三層,而這個拆法本身就是重點:

User:使用者流量,幾乎是平的
DC-DC: Synchronization:資料中心之間的同步流量
DC-DC: Gigawatt scale clusters:吉瓦級叢集之間的流量
從 2017 到 2026 預估,撐起整張圖的幾乎全是後面兩項,而 2026 那根「吉瓦級叢集」的柱子是從無到有直接長出來的。也就是說,資料中心之間的流量成長,跟使用者行為已經幾乎脫鉤了——是 AI 訓練自己產生的。
右邊 Cignal AI 的採用曲線則給了一個很能說服人的對照。圖上畫了 100G(2011)、200G(2014)、400G+(2017)、800G(2020)、400ZRx(2020)與 800ZRx(2025)六代技術,橫軸是「上市後第幾年」,縱軸是年出貨數。投影片的結論寫得很直接:
scale-across 的強勁需求,讓 800ZR+ 成為史上成長最快的 coherent 技術。
而 Acacia 自己的位置:
Acacia 是領先供應商,800ZR+ 模組已出貨超過 75,000 顆。
講者在台上補的那句更有意思:當年大家覺得 400ZR 的升級速度已經快到誇張,800ZR+ 直接把它甩開;而下一代 1600ZR/ZR+ 出來的時候,客戶的期待值會是同一套——新客戶會直接上 1600ZR+,不會再走一次階梯。
4. 從「幾個波長」到「幾條光纖」
這一段是我認為整場最被低估的觀察,而它只是講者順口帶過的一句話:
人們不再問「我需要幾個波長」,而是問「我需要幾條光纖」——這件事正在引發各式各樣的新討論。
為什麼這個提問方式的改變這麼重要?因為它代表 scale-across 的容量需求已經大到單一光纖的整個頻譜都不夠用的程度。一旦規劃單位從波長變成光纖,後面所有的工程問題都跟著換:
再生站的供電成了瓶頸。 講者明說:再生站(regenerator sites)已經供不起足夠的電,來點亮滿足容量需求所需的那麼多條光纖。這是一個電力問題,不是光學問題。
這逼出了新的光學設計。 既然要在第一天就把整條光纖點亮,就需要能一次處理整個波段的東西——全波段轉發器(full band transponders) 因此被拿出來討論。
整合度必須再往上。 投影片列的方向是:更高的鮑率以減少每個波段所需的波長數(C+L 已經廣泛部署,更多波段開始被考慮)、功耗與尺寸最佳化的架構、更高整合與更少的互連點(多軌放大、全波段轉發器、媒體轉換器),以及多芯光纖與空芯光纖。
關於媒體轉換器(media converter),講者給了一個很精準的定義:它是用設計彈性去換一個功耗最佳化的整合方案。投影片的圖把這件事畫得很清楚——原本 Client Optics → Client DSP → SerDes → 電氣連接器 → Line DSP → Line Optics 的一長串,塌縮成 Client Optics → 一顆同時做 Line 與 Client 的 DSP → Line Optics。少掉的那段電氣連接器與 SerDes,就是省下來的功耗。
投影片最後那行話很重要,因為它管住了所有這些新架構的期待值:
這些新架構預期將與可插拔方案並存。
講者還補了一個對供應鏈很有用的現況:今天的 scale-across 大多用的就是 DCI 的同一批技術,出貨時甚至很難分辨這顆是走傳統 DCI 還是 scale-across,很多情況下就是同一顆元件。 但他預期未來會看到更多為 scale-across 專門最佳化的設計。

5. 那條物理線:色散容忍度隨鮑率平方掉
如果這場只能留一張投影片,我會留這一張——因為它給的不是預測,是物理。
投影片的邏輯鏈是這樣走的:
第一,先承認 IMDD 的地盤。 資料中心內部的高量應用用的是 IMDD 光學,理由有兩個:已經建立的高量供應鏈,以及在可以做端到端 FEC 的地方,IMDD 的延遲低。
第二,然後畫出那條物理極限:
IMDD 的色散(CD)容忍度,隨鮑率的平方下降。 ・200G/lane 的 IMDD 極限大約是 10 公里 ・到了 400G/lane,超過 2 公里就需要 coherent
這一條把時間軸鎖死了。因為 400G/lane 不是遠期技術——它就在 2 到 5 年那一格。也就是說,「coherent 什麼時候進資料中心」這個問題,已經不是市場偏好問題,是鮑率翻倍之後的必然結果。
第三,標準已經先走了一步。 IEEE 已經把 ZR 技術拿去做 10 公里以上的 800G 介面——800GBASE-ER1 與 800GBASE-ER1-20 支援 20 公里與 40 公里鏈路。而投影片的下一句把未來也寫了出來:1600G/lane 的 coherent 技術可以支援超過 2 公里的校園級 DCI 應用。
第四,為什麼要從 IMDD 換到 coherent? 投影片列了四點:每個 lane 或波長四倍的容量、色散的數位補償、支援 DWDM、以及在需要的地方用更少的放大器。
右邊那張圖講者說他們「展示了將近十年,而它撐得很好」:橫軸是距離(0.5 km 到 1000 km,標示 Intra DC / Campus / Edge-ZR / Metro / LH-ULH),縱軸是資料速率(100G 到 3.2T),中間一條斜向的「Transition Phase」帶把 Direct Detect 與 Coherent 分開——而圖上那支大箭頭指向左邊:coherent 正在往更短的距離推進。
他對 coherent-lite 的態度則很克制,值得原樣記下來:IMDD 在資料中心內部仍然有效,也仍然會是資料中心內部的解法;但確實有一些應用場景,coherent 在資料中心內開始變得相關。 他還提醒:coherent-lite 不是一個應用,是一整個範圍的應用,每一個的需求都要分開看——而 OIF 正在做 coherent-lite 標準,試著劃出這些標準之間的邊界。

6. 把技術對到需求:從 CPO 到 ZR/ZR+ 的七階梯
這張圖是整場的收斂點,也是最實用的一頁。
Acacia 把七種光學方案排在一條從左上往右下的曲線上,對應四個尺度:交換機/機櫃尺度 → 列/建築尺度 → 校園尺度 → 都會尺度。而每一階旁邊標的不是規格,是它真正在取捨什麼:
CPO:供應鏈多樣性 vs 功耗/效能最佳化
NPO:前面板可維修,還是要拆機才能維修
LPO:距離、可靠度與互通性 vs 功耗與成本
LRO
FRO:距離——IMDD 與 coherent 的取捨
Coherent-lite
ZR/ZR+:一條光纖上的容量
這張圖的高明之處在於,它沒有宣布贏家。 講者在台上反覆強調這一點:「我不是來說哪個是正確答案的,我們整個產業需要對這些架構做實質的盡職調查,然後決定哪些是對的。」
他也給了一個對 CPO 與 NPO 的具體判斷:CPO 的架構更穩健、安全性明顯更好,但我們需要更多的可見度,才能理解這兩個方案在可擴展性上的比較關係。 而 LPO/LRO 相對於傳統可插拔的那段比較,他的態度是:如果有好的論證說明我們可以達到同樣的效果與同樣的品質,那省下來的功耗當然是加分——但我們需要更多資料。
快窄與慢寬這一整場辯論,以及各方案在其中的位置,我們整理在 ECOC2026 | 快窄與慢寬吵了三小時,沒有人先定義「慢」:這場辯論真正的分水嶺是 448G。
7. 液冷與 XPO:第一個為液冷定義的封裝規格
這一段短,但訊息量不小。
投影片列的是:液冷在運算端已經很普遍,並且會在網路端變得更普及——理由是降低設施的冷卻功耗,以及讓更高功率密度的設計成為可能。現況是:今天的可插拔光學支援氣冷或冷板(cold plate)設計;而為液冷做最佳化的設計,可以提高系統密度。
然後是那句結論:
XPO 是業界第一個為液冷最佳化而定義封裝規格的努力。
這句話值得台廠特別注意。因為它把液冷從「機房的事」拉進了「光模組封裝規格」的層次——一旦封裝規格本身是為液冷設計的,散熱介面、機構件、密封、快接頭這些東西就會進入光模組的物料清單。 那是一個目前還沒有定型的新料件市場。
講者對液冷的態度同樣保持開放:他說現在大家對液冷怎麼進網路設備有很多不同看法,而他更在意的是有沒有問對問題——如果液冷池(cooling loop)的配置是對的,你就能完全利用它的好處;「我不確定那是不是正確答案,但我認為那是我們應該問的正確問題。」
8. 總結
這場的價值不在單一數字,在它給了一套可以拿來評估所有新技術的共同尺規。而這套尺規對台灣供應鏈有三個很具體的意義。
第一,賣點要從「省多少電」改成「保住多少 GPU 使用率」。 這不是換個說法而已。當客戶的第一指標是 GPU 使用率時,可靠度、MTBF、良率一致性、以及「壞了能不能不停機換掉」的可維修性,全部從加分項變成必要條件。注意 Acacia 在 NPO 那一階標的取捨不是功耗,是「前面板可維修,還是要拆機」——這是一個純機構、純運維的判準,而它被放在和功耗同等的位置上。能在這一欄提出數據的供應商,會比只能報 pJ/bit 的供應商更容易進到評估名單。
第二,那條 400G/lane 的物理線,是可以拿來做產品規劃的硬時間表。 IMDD 的色散容忍度隨鮑率平方下降,200G/lane 撐到 10 公里,400G/lane 過 2 公里就得 coherent——而 400G/lane 就在 2 到 5 年那一格。也就是說,校園級 DCI(2–10 公里)這一段的技術歸屬,會在下一個世代被強制換手。 做 EML、做 DR/FR 光模組的要想清楚:你在 400G/lane 世代還剩多少地盤;而做 coherent 相關(DSP 周邊、TFLN、ICR/ITLA、C+L 放大)的,則要準備好那段需求會提前到來。
第三,「幾條光纖」這個提問方式,會把價值往光纖與連接器端移。 當再生站的供電成為容量上限、當全波段轉發器與多芯/空芯光纖被放進同一張投影片,瓶頸就從模組移到了光纖本身與它的管理。這對台廠是機會也是警訊:機會在多芯光纖的對位、光纖束、高密度連接器與 MPO 演進;警訊是如果整個產業真的轉向「一次點亮整條光纖」,那按波長賣的模組數量成長曲線會被重新畫過。
宣判:Acacia 這場沒有發表任何新產品,但它是整屆 ECOC 最值得台廠逐頁讀的一場,因為它把甲方真正的評分表攤開了。 那張七階梯圖裡沒有贏家,只有取捨——而每一格取捨的旁邊,都是一個台廠可以切進去的題目。真正該焦慮的不是 CPO 會不會贏,而是當客戶的第一指標從 $/bit 換成 GPU 使用率之後,你手上的規格書還能不能回答他真正在問的問題。
本文僅供技術與產業趨勢分析,不構成任何投資建議。
相關閱讀
銅纜撐不住 AI 之後:scale-up 光互連的七條路,與各撞一堵牆的兩種活法:scale-up 端的七條路線對照,與 Acacia 這張 scale-across 階梯圖互補
ECOC2026 | 快窄與慢寬吵了三小時,沒有人先定義「慢」:這場辯論真正的分水嶺是 448G:每 lane 速率翻倍為什麼是所有架構決策的起點
ECOC2026 | 資料中心要幾十億顆雷射,卡住的卻是「接上去」那 5 分鐘:當規劃單位從波長變成光纖,封裝與對準的產能瓶頸會被放大幾倍


留言