


ECOC2026 | VCSEL 早就打到 ≤1 pJ/bit,卡住它的是光纖——NVIDIA 為此暫停了 slow-and-wide 專案?並開出一條 26/80 的新規格
NVIDIA 的 Daniel Kuchta 做了一場 VCSEL 全景回顧,而結論投影片上那一行把整場定調了:「≤1 pJ/bit all-in 已經被多家公司做到——其他技術很難打贏。」 注意「all-in」兩個字,這是含驅動、含 TIA、含一切的端到端數字,而同一屆 Microsoft 為機櫃內光 I/O 訂的門檻就是 <1 pJ/bit。也就是說,在功耗這一欄,VCSEL 已經在終點線上了。 但這場演講真正的訊息藏在另外兩段:200G 大概是現有氧化侷限結構能擠出的最後一代;以及卡住規模化的不是雷射,是光纖與連接器——NVIDIA 自己的 slow-and-wide 研究專案,就是因為光纖成本太高而被按下暫停鍵。講者因此在台上做了一件很少見的事:公開提案一條新光纖規格,26 µm 芯徑、80 µm 玻璃、1060 nm、EMB 約 5 GHz。
1. VCSEL 為什麼還在桌上:一行結論解決所有爭論
先把這場的立場講清楚。講者開場就聲明這是一場綜覽,涵蓋多家公司的技術,不代表 NVIDIA 對任何一家的背書。
VCSEL 的優勢清單,投影片列了七項:最低的每位元能耗、最低的每通道成本、容易做成高密度平行陣列(還能多放幾條做備援)、與多模光纖的簡單耦合、可用不同供應鏈大規模製造、可做晶圓級測試與老化、以及無錯誤的低延遲 NRZ 操作。
而總結投影片上那一行是整場最該被記住的:
≤1 pJ/bit all-in 已經被多家公司展示——其他技術很難打贏。
把這句話放進 ECOC 2026 的脈絡就很有意思了。Microsoft 在同一屆把機櫃內光 I/O 的功耗門檻訂在 <1 pJ/bit,而他們押的是 microLED。但 Kuchta 這張投影片說的是:這個數字,VCSEL 現在就有,而且不只一家。
這不是說 VCSEL 贏了。它說的是,如果你的評分表上只有 pJ/bit 這一欄,那這場比賽早就結束了——所以真正的戰場一定在別的地方。 而這場演講剩下的四十分鐘,就是在講那些「別的地方」。
2. 速度紀錄還在刷新,但要看有沒有報 BER
高速 VCSEL 的文獻進展被畫成一張圖:橫軸是 FEC 修正後的資料速率,縱軸是光纖長度,超過 200 公尺的點全部是單模光纖。而 100G/λ PAM-4 已經是商用品——400G-SR4、400G-SR4.2、200G-SR2、200G bidi 都在用;100G/λ 的 NRZ 則是新發展。
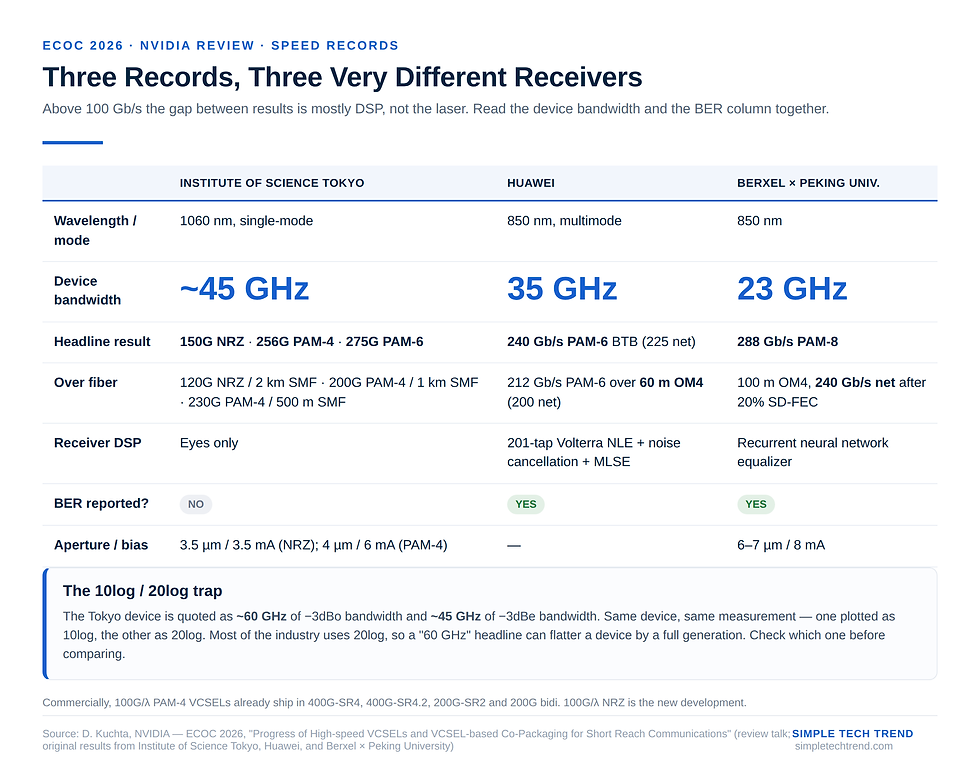
三個紀錄值得抄下來,但要分開看:
Institute of Science Tokyo(1060 nm 單模 VCSEL,背對背,只有眼圖)
150G NRZ:ER 1.8 dB、3.5 µm 氧化孔徑、3.5 mA 偏壓
256G PAM-4:ER 2.2 dB、TDECQ 約 5 dB、4 µm 氧化孔徑、6 mA 偏壓
275G PAM-6
另外也做到 120G NRZ 跑 2 km 單模、200G PAM-4 跑 1 km 單模、230G PAM-4 跑 500 m 單模
這組數字的元件頻寬標示很值得注意:投影片同時標了 −3dBo 頻寬約 60 GHz 與 −3dBe 頻寬約 45 GHz。這是同一顆元件的同一件事,只是一個用 10log、一個用 20log。 講者在台上特別點名這件事,因為業界多半用 20log——看到 60 GHz 的時候要先確認是哪一種,否則會高估一個世代。 而投影片右上角那個方框也很誠實:「沒有報 BER」。
Huawei(850 nm 多模 VCSEL,35 GHz 頻寬,有報 BER)
240 Gb/s PAM-6 背對背,淨速率 225 Gb/s
212 Gb/s PAM-6 跑 60 m OM4,淨速率 200 Gb/s
接收端用了 201 抽頭的 Volterra 非線性等化器 + 雜訊消除 + MLSE
Berxel × 北京大學(850 nm,PAM-8 紀錄 288 Gb/s)
元件只有 23 GHz 頻寬、6–7 µm 氧化孔徑、8 mA 偏壓
跑 100 m OM4,接收端用遞迴神經網路(RNN)等化
20% 軟判決 FEC 後淨速率 240 Gb/s
把這三組並排看,訊息很清楚:紀錄的差異有一大半在 DSP,不在雷射。 Berxel 那顆 23 GHz 的元件能跑出 288 Gb/s,靠的是神經網路等化器;Huawei 那顆 35 GHz 的靠的是 201 抽頭 Volterra。這正好是「快而窄」路線的代價——而這一代的 pJ/bit 爭論,很大一部分就是在爭這些 DSP 該不該算進去。 這個口徑問題我們在 ECOC2026 | 快窄與慢寬吵了三小時,沒有人先定義「慢」:這場辯論真正的分水嶺是 448G 拆過。
3. 商用 200G VCSEL 的真相:紀錄很漂亮,貨還沒到
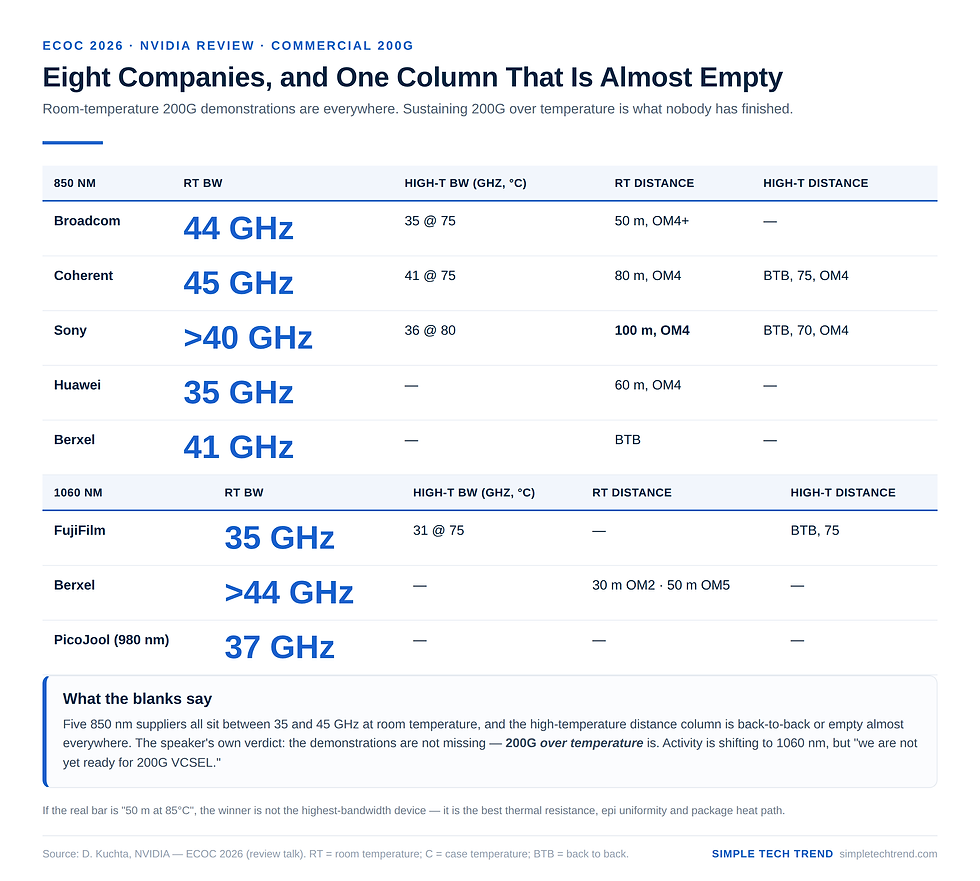
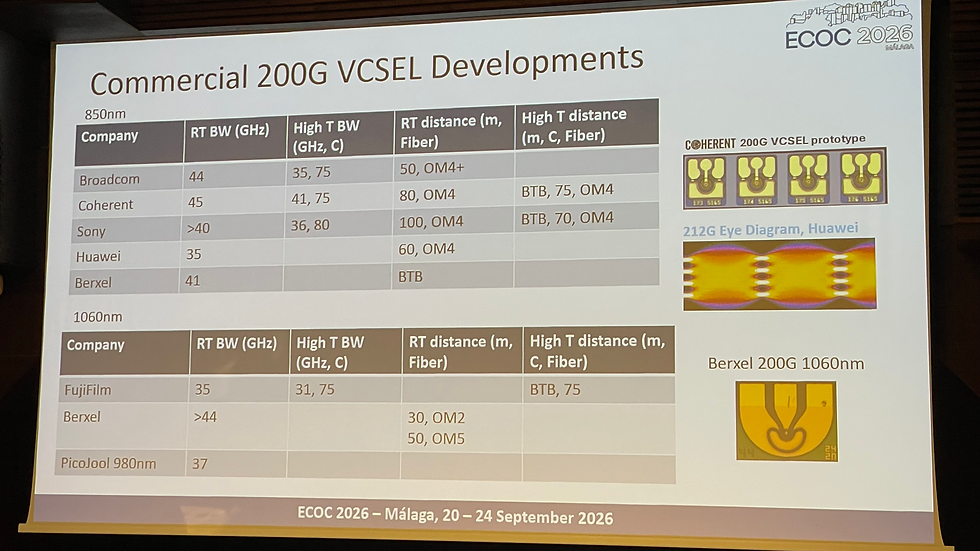
這是整場我認為對供應鏈最有價值的一張表。講者把在發展 200G VCSEL 的公司按波長分成兩組,列出室溫頻寬、高溫頻寬、室溫距離、高溫距離四欄。
850 nm 陣營(五家)
Broadcom:室溫頻寬 44 GHz;高溫頻寬 35 @ 75°C;室溫距離 50 m, OM4+;高溫距離 —
Coherent:室溫頻寬 45 GHz;高溫頻寬 41 @ 75°C;室溫距離 80 m, OM4;高溫距離 BTB @ 75°C, OM4
Sony:室溫頻寬 >40 GHz;高溫頻寬 36 @ 80°C;室溫距離 100 m, OM4;高溫距離 BTB @ 70°C, OM4
Huawei:室溫頻寬 35 GHz;高溫頻寬 —;室溫距離 60 m, OM4;高溫距離 —
Berxel:室溫頻寬 41 GHz;高溫頻寬 —;室溫距離 背對背;高溫距離 —
1060 nm 陣營(三家)
FujiFilm:室溫頻寬 35 GHz;高溫頻寬 31 @ 75°C;室溫距離 背對背 @ 75°C
Berxel:室溫頻寬 >44 GHz;高溫頻寬 —;室溫距離 30 m OM2/50 m OM5
PicoJool(980 nm):室溫頻寬 37 GHz;高溫頻寬 —;室溫距離 —
這張表最該看的是那些空白格。 850 nm 這邊,五家都有室溫元件、頻寬都在 35 到 45 GHz 之間,但「高溫距離」這一欄幾乎全是背對背或空白。 講者講得很直白:室溫的展示不缺,缺的是「跨溫度支援 200G」。
而 1060 nm 這邊雖然家數少,活動量卻在上升——Berxel 的 1060 nm 元件室溫頻寬已經 >44 GHz,還跑了 30 m OM2 與 50 m OM5。講者自己的判斷是:「我不知道 200G VCSEL 什麼時候會商用化。活動主要在 1060 nm 那邊推進,所以我們可能會在那裡先看到——但即使有了這些展示,我們還沒準備好。」
對台廠而言,這一欄空白就是機會,也是警訊。 如果 200G VCSEL 的真正門檻是「85°C 還能跑 50 公尺」,那贏家不會是頻寬最高的那家,而是熱阻管理、磊晶均勻度與封裝散熱最好的那家。 這是製造與材料的競爭,不是元件物理的競爭。
4. VCSEL 的 CPO/NPO 已經有東西可以摸了
這一段推翻了一個常見印象——很多人以為 CPO 就等於矽光子。實際上 VCSEL 版本的 CPO 與 NPO 已經有好幾個可量測的實體。
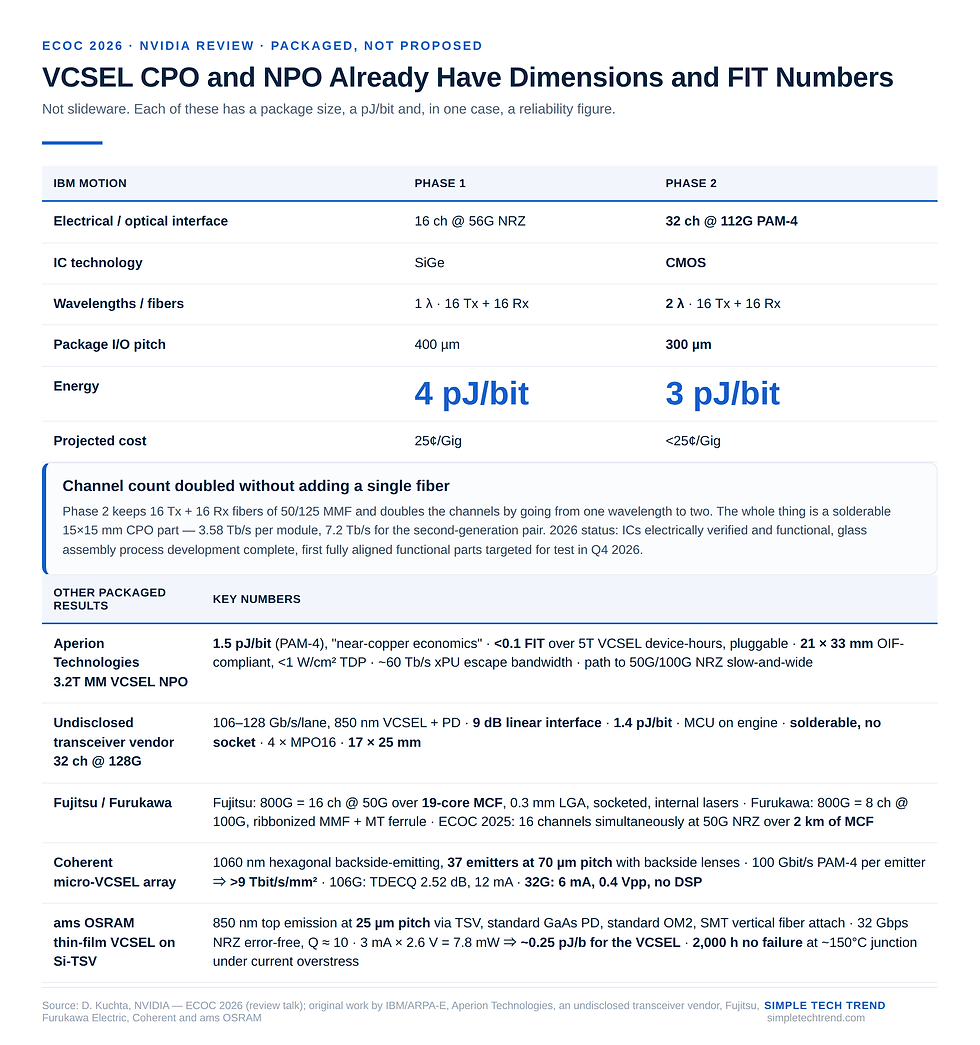
IBM MOTION(ARPA-E 計畫)是講者自己在 IBM 時做的專案,而這次給了完整的兩代對照:
電氣介面:Phase 1 為 16 通道 @ 56G NRZ;Phase 2 為 32 通道 @ 112G PAM-4
IC 製程:Phase 1 為 SiGe;Phase 2 為 CMOS
波長數:Phase 1 為 1;Phase 2 為 2
光纖數與型別:兩代都是 16 Tx + 16 Rx、50/125 MMF
封裝 I/O 間距:Phase 1 為 400 µm;Phase 2 為 300 µm;玻璃載板兩代都是 13×13 mm
能耗:Phase 1 為 4 pJ/bit;Phase 2 為 3 pJ/bit
預估成本與介面:Phase 1 為 25 美分/Gig,Phase 2 低於 25 美分/Gig;兩代都是焊接或 LGA
注意光纖數沒變但通道數翻倍——靠的是波長從 1 變成 2。整顆是 32 通道 @ 112G PAM-4 塞在 15×15 mm 的可焊接 CPO 方案裡,等於 3.58 Tb/s。Phase 1 的模組是 1.8 Tb/s,第二代兩顆併起來是 7.2 Tb/s。
2026 的狀態也講得很具體:所有次組件都已製造完成、收發 IC 電氣測試完成且功能正常、玻璃組裝製程開發完成、IC/VCSEL/PD 組裝進行中,第一批完整對準的功能件預計 2026 年第四季可測。
Aperion Technologies 的 3.2T 多模 VCSEL NPO 封裝則給了這場最硬的幾個數字:
能效 1.5 pJ/bit(PAM-4),投影片的原話是「接近銅的經濟性」
可靠度 <0.1 FIT,基於 5 兆 VCSEL 元件小時,而且是可插拔架構
21 × 33 mm 的 OIF 相容封裝,TDP <1 W/cm²
約 60 Tb/s 的 xPU escape 頻寬
可擴展路徑:50G/100G NRZ 的慢而寬架構,並朝單一光連接器整合
還有一家未具名的收發器廠商:32 通道、106–128 Gb/s/lane、850 nm VCSEL + PD、9 dB 線性介面、1.4 pJ/bit、引擎上帶 MCU、可焊接(不用插座)、4 × MPO16 光介面、17 × 25 mm。
這三個加起來說明一件事:VCSEL 的 CPO/NPO 不是投影片,是已經有尺寸、有 pJ/bit、有 FIT 數字的東西。 而 1.4 到 1.5 pJ/bit 這個區間,正好落在矽光子 CPO 目前喊的 <5 pJ/bit 與 Microsoft 的 <1 pJ/bit 之間。
另外兩家日本廠商也在同一個方向:Fujitsu 用 19 芯多芯光纖,800G = 16 通道 @ 50G,0.3 mm 間距 LGA、插座式、內建雷射、垂直連接器;Furukawa 走帶狀多模光纖,800G = 8 通道 @ 100G,MT 插芯加微透鏡陣列。ECOC 2025 的論文已經做到16 通道同時以 50G NRZ 跑 2 km 多芯光纖。
5. 那個提案:一條 26/80 的新光纖
這是整場最有「立場」的一段,也是我認為最該被台灣光纖與連接器供應鏈看到的一段。
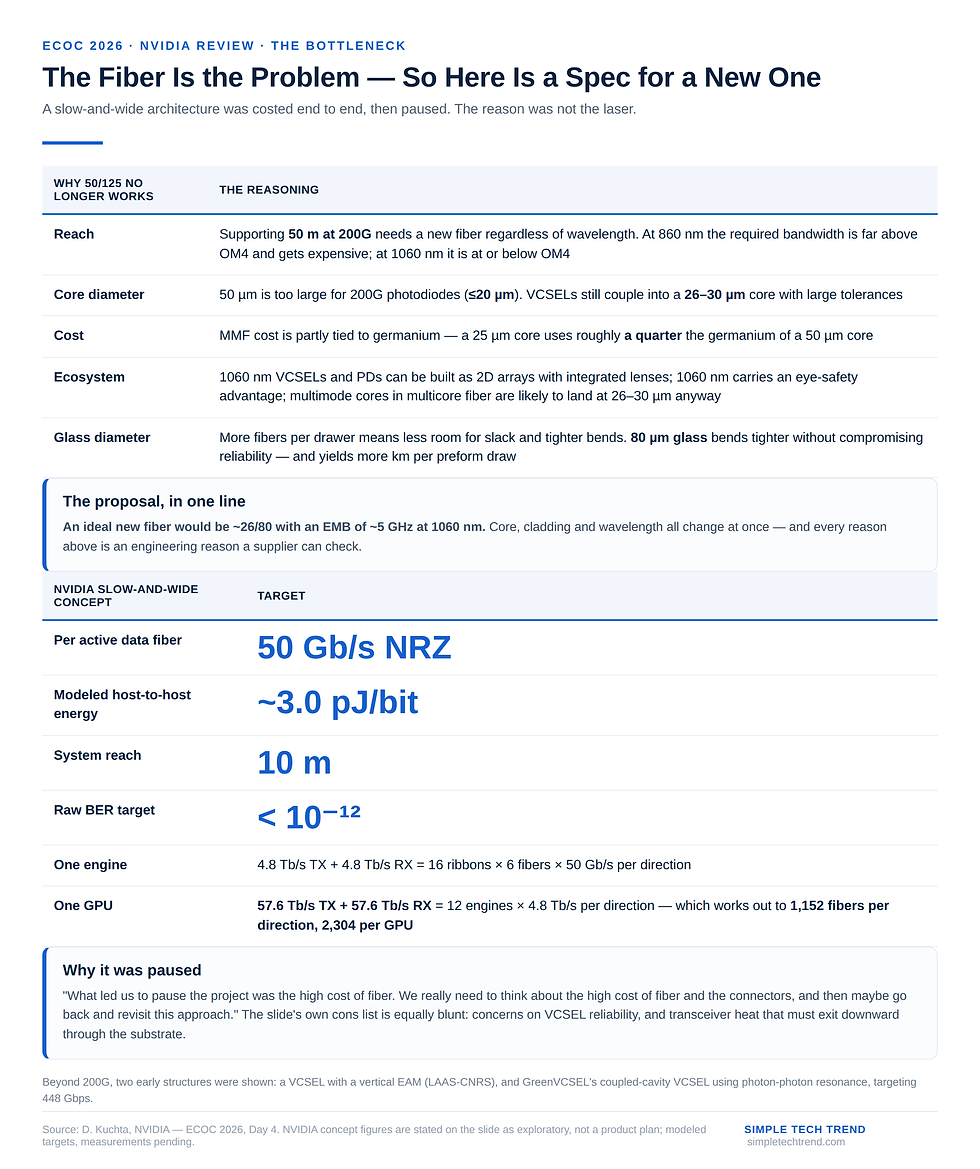
問題的起點很簡單:要在 200G 下跑 50 公尺,不管哪個波長,都需要一條新光纖。
在 860 nm,需要的光纖頻寬遠高於 OM4,會讓光纖更貴
在 1060 nm,因為色散低很多,需要的光纖頻寬低於或等於 OM4
講者的判斷是:既然 OM5 這類新光纖已經很貴了,不要再往 850 nm 堆更高頻寬的光纖,往 1060 nm 走反而可以做出更便宜的光纖。
但他接著說「這還不夠」,然後列出幾個理由要把芯徑也砍掉:
50/125 µm 的芯太大了,對 200G 的光偵測器(≤20 µm)來說不匹配
VCSEL 仍然可以用很大的容差耦合進 26–30 µm 的芯
多模光纖的成本有一部分綁在鍺上,芯小就應該更便宜(25 µm 芯的鍺用量只有 50 µm 芯的四分之一)
1060 nm 的 VCSEL 與 PD 可以做成帶整合透鏡的二維陣列,而且1060 nm 有眼睛安全上的優勢
多芯光纖的多模芯,本來就很可能落在 26–30 µm
然後他說「這還是不夠」,再砍玻璃外徑:
125 µm 的玻璃外徑太大了
每個抽屜要塞更多光纖,留給鬆弛的空間更少,彎曲半徑就更緊
80 µm 的玻璃可以彎得更緊而不犧牲可靠度
80 µm 的玻璃,同一根預型棒可以拉出更多公里
結論那一行寫得非常具體:
理想的新光纖應該是大約 26/80,在 1060 nm 下 EMB 約 5 GHz。
這是一個在 IEEE 社群正在推的提案,而且它同時動了芯徑、玻璃外徑與波長三件事。 對台灣的光纖、連接器與被動元件廠,這是一個罕見的「規格還沒定、但需求已經被公開講出來」的窗口——而且講的人是 NVIDIA。
6. 慢而寬的真實帳:57.6 Tb/s 一顆 GPU,然後專案暫停了
這一段是這場最誠實的部分,也是整個 ECOC 2026 上少數有人公開講「我們算過,然後停了」的案例。
先看 NVIDIA 研究部門那個慢而寬的概念設計,數字都在投影片上:
每條有效資料光纖:50 Gb/s NRZ
模擬的端到端能效:約 3.0 pJ/bit(host-to-host)
系統距離目標:10 m
原始 BER 目標:<10⁻¹²
架構是帶透鏡的 VCSEL 與 PD 晶片做成 CMOS 光背板,加上垂直光纖連接器。而容量是這樣堆上去的:
一個引擎:4.8 Tb/s TX + 4.8 Tb/s RX=16 條 ribbon × 6 條光纖 × 50 Gb/s(每方向)
一顆 GPU:57.6 Tb/s TX + 57.6 Tb/s RX=12 個引擎 × 4.8 Tb/s(每方向)
把這組數字算到底:一顆 GPU 單方向要 1,152 條光纖,雙向就是 2,304 條。 而講者在台上提到,他們一度把整個機房算過一遍,得到六萬條光纖的規模。
然後他說了這場最重要的一句:讓我們暫停這個專案的,是光纖的高成本。
原話是:「真正讓我們停下來的是光纖的高成本。我們真的需要重新思考光纖與連接器的成本,然後也許再回頭重新檢視這個方法。」
投影片上那頁「未來選項:慢而寬 VCSEL 陣列」也把優缺點列得很坦白——優點是功耗與成本效率的潛力、通訊通道簡單;缺點是對 VCSEL 可靠度的疑慮,以及收發器的熱必須往下穿過基板排掉。
這一段把「慢而寬」從理念層次拉回到帳本層次。 我們在 銅纜撐不住 AI 之後:scale-up 光互連的七條路,與各撞一堵牆的兩種活法 講過快而窄與慢而寬各自會撞一堵牆——而 NVIDIA 這個案例給出了慢而寬那堵牆的確切名字:光纖與連接器的單價。
同一段裡的其他玩家也都在往密度走,而且都給了硬數字:
ams OSRAM:850 nm 薄膜 VCSEL 做在矽 TSV 上,整合已完成。25 µm 的密集間距、標準 GaAs 光偵測器、標準 OM2 光纖、可用 SMT 生態系做垂直光纖貼裝。32 Gbps NRZ 無錯誤操作,Q 因子約 10,3 mA × 2.6 V = 7.8 mW,換算約 0.25 pJ/b(僅 VCSEL)。可靠度模型顯示在約 150°C 接面溫度與電流過應力下 2,000 小時無失效。
Coherent:1060 nm 的六角形背面發射微型 VCSEL 陣列,37 個發射器、70 µm 間距、含背面透鏡。單一發射器頻寬可到 100 Gbit/s(PAM-4),推得頻寬密度 >9 Tbit/s/mm²。106 Gbit/s 時 TDECQ 2.52 dB、電流 12 mA、收發各 7 抽頭;32 Gbit/s 時電流 6 mA、Vpp 0.4 V、完全不用 DSP。
Coherent 那個 >9 Tbit/s/mm² 值得單獨圈起來。 對照 Microsoft 為光 I/O 訂的 >10 Tbps/mm(線性岸線密度)與 NVIDIA 微環測試晶片的 1.33 Tb/s/mm²(面積密度)——微型 VCSEL 陣列在面積密度這一欄,目前是領先的。
7. 200G 之後還有路嗎:兩條早期路線
講者對現有結構下了一個明確的判斷:200G 大概會是現有「調變氧化侷限結構」能榨出來的最後一個資料速率。要再往上,需要新的做法。
投影片上給了兩條,都還很早期:
第一條,VCSEL + 垂直 EAM。 來源是 LAAS-CNRS,在 VCSEL 上方垂直整合一個電吸收調變器,投影片評語是「有很高的潛力做到更高頻寬」。
第二條,耦合腔 VCSEL。 GreenVCSEL 與一家主要 VCSEL 供應商合作,結構是上方一個電流泵浦的主動腔、中間一層 DBR、下方一個被動腔,利用光子-光子共振做光學增強調變。目標是 448 Gbps。
448 這個數字不是隨便選的。 它正好對上這一屆 workshop 上吵得最兇的那條線——快而窄陣營想把單通道推到 448G 的那條路。如果耦合腔 VCSEL 真的做到了,那快而窄與慢而寬的分界線會被重新畫一次。 講者自己的說法很克制:「我們的模擬顯示它應該可以支援 448 Gbps。我祝他們好運。」
8. 總結
把這場放進 ECOC 2026 的座標,它的位置很特別:在一個大家都在談矽光子與 microLED 的會期裡,這是唯一一場站出來說「VCSEL 的能效問題早就解決了」的演講。
講者自己的用詞很有畫面:「儘管矽光子把房間裡的空氣都吸走了,VCSEL 這邊還是有很多好東西在發生。」
對台灣供應鏈,三個具體落點:
第一,功耗這一欄不要再拿來當 VCSEL 的疑問。 ≤1 pJ/bit all-in 已經被多家做到,Aperion 的 1.5 pJ/bit 是整顆 3.2T NPO 封裝的數字、ams OSRAM 的 0.25 pJ/b 是 VCSEL 元件本身。真正該問的三個問題換成了:85°C 跑不跑得到 50 公尺、可靠度撐不撐得住共封裝、以及光纖與連接器多少錢。
第二,那個 26/80 的提案是一個罕見的公開需求訊號。 它同時要求芯徑從 50 降到 26、玻璃外徑從 125 降到 80、波長從 850 換到 1060,而理由全部是可驗證的工程理由——PD 尺寸、鍺用量、彎曲可靠度、預型棒拉絲長度、眼睛安全。 對光纖與連接器廠,這是一份還沒標準化、但已經被 NVIDIA 公開講出規格的訂單需求。而且它同時打開了 1060 nm 的 PD、透鏡陣列與 MT/多芯插芯的機會。
第三,也是最該被當成警告的——NVIDIA 自己算完慢而寬,是因為光纖成本而暫停的。 一顆 GPU 2,304 條光纖、一個機房六萬條,這個量級下光纖與連接器的單價就是整個架構的成敗。這對台廠是壞消息也是好消息:壞消息是慢而寬的落地時間會比大家想的晚;好消息是,誰能把那條 26/80 光纖與對應的連接器做到夠便宜,誰就是解鎖這條路線的人。
宣判:這場演講最有價值的不是任何一項技術進展,是它把 VCSEL 的競爭焦點從「夠不夠快、夠不夠省電」正式移到了「光纖與連接器夠不夠便宜」。當一家 GPU 公司算完自己的慢而寬架構、然後因為光纖成本按下暫停鍵,並在台上公開提案一條新光纖規格——這已經不是元件層級的討論了。VCSEL 的下一步不在磊晶廠,在拉絲塔與插芯的模具裡。
本文僅供技術與產業趨勢分析,不構成任何投資建議。
相關閱讀
ECOC2026 | 快窄與慢寬吵了三小時,沒有人先定義「慢」:這場辯論真正的分水嶺是 448G:448G 這條線為什麼是分水嶺,以及 pJ/bit 口徑為何會差到五十四倍
ECOC2026 | 資料中心要幾十億顆雷射,卡住的卻是「接上去」那 5 分鐘:光源的產能瓶頸不在發光,在封裝與對準——與本文「卡住的是光纖」互為同一個故事的兩面
銅纜撐不住 AI 之後:scale-up 光互連的七條路,與各撞一堵牆的兩種活法:快而窄與慢而寬各自會撞的那堵牆,以及七大方案怎麼分層共存


留言