


2026 OCP Global Summit | SemiAnalysis | Dylan Patel | From Silicon to Services
1. 為何是 SemiAnalysis 來講「從矽到服務」
SemiAnalysis 目前約 110 人、分布 15 個國家(口頭),團隊背景從設備商、晶圓廠研發、晶片設計,一路到 hyperscaler 部署與電廠建設。投影片列出它手上的產品:14 套機構模型、2 套開源跑分(InferenceX、AgentX)、1 套雲端評級(ClusterMAX)、1 個免費 GPU 價格指數。它在 Oregon 另有一座逆向工程實驗室,設備超過 1,000 萬美元(口頭),最近拆的是 Intel 18A 與 Samsung SF2 兩種 2 nm 級製程。
我們在 2026 OCP APAC Summit|SemiAnalysis|Scale Up Sophistry 拆過它對 scale-up 銅與光的看法。這次 Global Summit 的焦點完全不同:不是互連用哪種介質,而是整座機房最後交出多少 token。
互連、記憶體、電力的所有爭論,最終都要換算成同一個分母:每 MW 能賣出多少 token。
2. 拆解需求端:agentic 已經是主流流量
Patel 的第一個論點是,舊跑分的「固定輸入輸出比」已經過時。真實的 agentic coding 是模型回合與工具呼叫交替進行,工具執行期間 GPU 不產生 token,必須靠連續批次把其他使用者塞進來,才能把硬體跑滿。
SemiAnalysis 的 AgentX 就是為此而做:
從 8,300 個真實 Claude Code session(340 萬次請求、300 萬美元以上花費)中挑出 393 個匿名 session 重播
輸入長度 P50/P90/P99 分別是 88K/272K/675K token,最大 context 1M
44% 的 session 會啟動 subagent
需求端的證據來自 OpenAI 自己的數據:企業版輸出 token 中,Codex 占比在 2026 年 2 月 Codex macOS app 推出後加速,6 月達 64%,ChatGPT 剩 36%。Patel 口頭補充,現在比例「更高」。
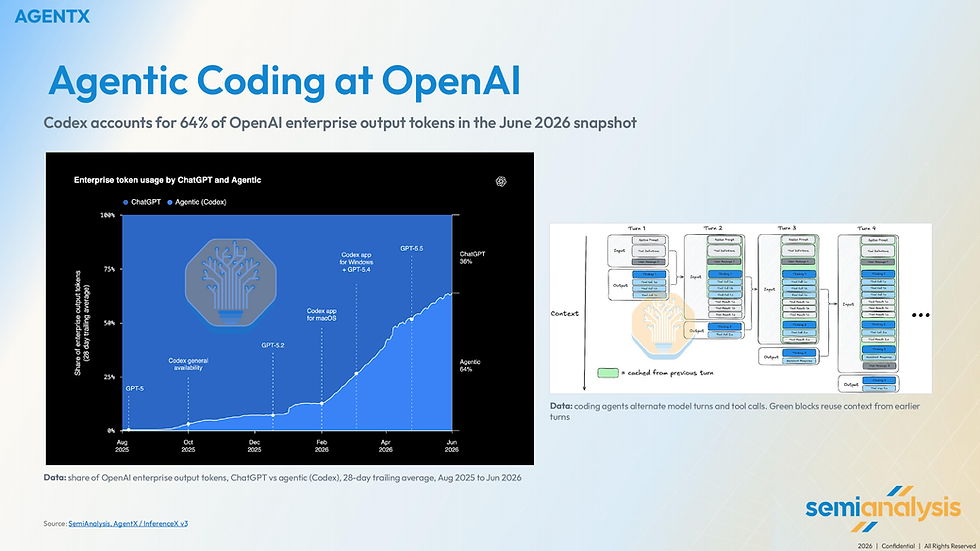
▲ OpenAI 企業版輸出 token 中 agentic(Codex)占比,從 2025 年 8 月趨近零升到 2026 年 6 月的 64%(圖片來源:SemiAnalysis|2026 OCP Global Summit 簡報(第 8 頁))
這對硬體的意義很直接:context 變長,KV cache 變大,記憶體容量和頻寬成為瓶頸。投影片上的一個數字可以佐證:vLLM 開啟 CPU KV offload 後,輸出吞吐量提升 81.7%。
3. 拆解供給端:Rubin 的 7.2 倍只出現在 150 tok/s
這是整場最有分量的一張表。條件是 DeepSeek V4 Pro(1.6T 參數)、AgentX 工作負載、FP4,單位是每 MW 全口徑電力的百萬 tok/s。Rubin 用的還是預發布軟體。
P90 互動速度(tok/s/user) | 最佳 GB300(M tok/s/MW) | Vera Rubin NVL72(M tok/s/MW) | Rubin/GB300 |
75 | 44.14 | 64.00 | 1.45x |
100 | 28.47 | 59.38 | 2.09x |
125 | 12.01 | 51.55 | 4.29x |
150 | 5.14 | 36.98 | 7.19x |
170 | 3.92 | 21.78 | 5.56x |
200 | 2.73 | 7.43 | 2.72x |

▲ Vera Rubin NVL72 相對最佳 GB300 的每 MW token 產出倍數,在 150 tok/s/user 達到 7.19 倍高峰,兩端收斂(圖片來源:Simple Tech Trend 自製,資料來源 SemiAnalysis 2026 OCP Global Summit 簡報)
這裡要看清楚三件事:
每顆晶片更耗電。SemiAnalysis 模型中的全口徑單晶片功耗,VR200 是 3.3 kW,GB300 是 2.12 kW,增加約 56%(STT 計算)。在每 MW 計價的框架下,這不是缺點,因為產出增加得更快。
倍數不是單一數字。過去社群習慣「每代效能 2 倍、價格貴 50%」,Patel 說這套經驗在模型、硬體、軟體協同最佳化之下已經失效,但倍數高度依賴操作點。
商用服務落在 75–150 tok/s/user(口頭)。這代表 OpenAI、Anthropic 這類以互動體驗為主的服務,換 Rubin 的回報最高;跑低速批次推論的業者,升級急迫性低很多。
在電力就是上限的機房裡,這張表就是換機的時間表。
4. 拆解成本:同一個模型,晶片排名會翻轉
InferenceX 每天在 GitHub Actions 上重跑,覆蓋 13 種加速器 SKU、10 套以上 serving stack。SemiAnalysis 用自己的 TCO 模型把每顆晶片換算成每小時成本(以 hyperscaler 規模自持計):H100 1.17、B200 1.73、B300 2.26、GB300 2.31、MI355X 1.50 美元;TPUv7 用 Google 內部 TCO 是 1.03 美元。
套上這組成本,結論隨操作點改變:
NVIDIA 在多數區段領先:Qwen3.5 在 90 tok/s/user,NVIDIA 對 AMD 的差距超過 20 倍;GLM 5.3 在 150 tok/s/user,成本效率最高差 5 倍。低速區段兩者差距小很多。
AMD 拿下最右端:MI355X 用 vLLM 做 prefill、TileRT 做 decode,P90 互動速度峰值約 470 tok/s/user,NVIDIA 在其測試的引擎上都跑不到這個速度。但投影片也註明 TTFT 較高,單看峰值速度不代表成本效率勝出。
TPU 在 100 tok/s/user 最省:Qwen3.5 397B、FP8、8K/1K,外部 TCO 下每百萬 token 成本 TPUv7 是 0.181 美元,比 B200 低約 18%、比 B300 低約 34%(STT 計算)。投影片顯示低延遲區段由 B200 與 GB200 領先,延遲放寬後換 TPUv7 領先。這仍是 preview,FP4、分離式 prefill/decode、MTP 與 AgentX 都還沒納入。
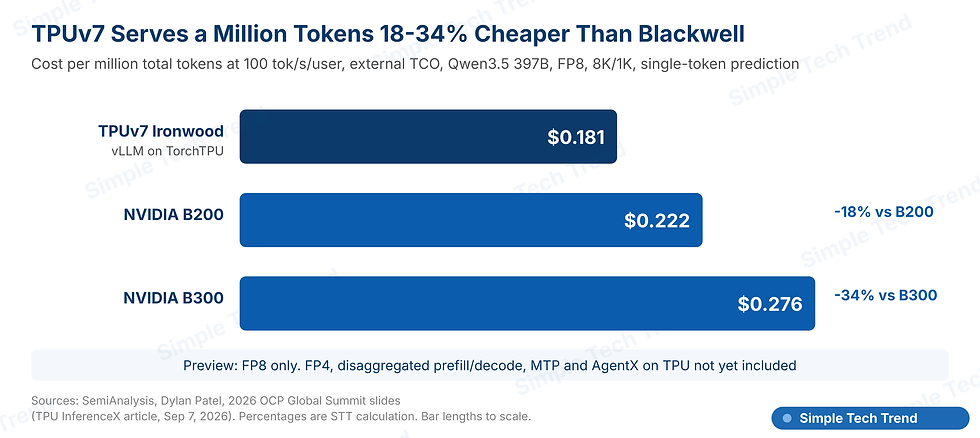
▲ 100 tok/s/user 下每百萬 token 成本,TPUv7 0.181 美元,低於 B200 的 0.222 與 B300 的 0.276(圖片來源:Simple Tech Trend 自製,資料來源 SemiAnalysis 2026 OCP Global Summit 簡報)

▲ AMD MI355X 搭 TileRT 在 GLM 5.2/5.3 上跑到約 470 tok/s/user,超出 GB300 曲線範圍(圖片來源:SemiAnalysis|2026 OCP Global Summit 簡報(第 11 頁))
Q&A 還有一個值得記下的訊號:SemiAnalysis 測過 OpenAI 自研晶片 Jalapeno,Patel 說它在開源模型上全曲線勝過 GB300,但明年才會放量(口頭)。
5. 拆解服務端:上百家在賣 token,能大量供貨的很少
Patel 對推論市場的描述很具體:向雲端租 GB300、跑開源模型與開源框架,在高利用率下可以做到約 70% 毛利(口頭)。因此市場上已有 100 家以上業者在賣 token。
但供給高度集中:多數業者只拿得到幾十櫃、數百到數千顆 GPU;能大量供貨的是 Amazon Bedrock(數十萬顆 Trainium 與 GPU)與 Fireworks(數萬顆 GPU)這一級(口頭)。ClusterMAX 的數據呼應這點:追蹤 323 家雲端業者、實際評測 77 家,只有 19 家拿到評級,約為受評業者的四分之一。
另一個挑戰是品質不一致。同一個開源模型在不同供應商上的 coding 評測結果可能差很多,因為部分業者為了成本做了犧牲精度的最佳化。Patel 提到 token 路由平台正在興起,市場最後是向大型業者整併,還是由路由層撮合小業者,他沒有下定論。
接下來 6 到 12 個月的觀察時程,SemiAnalysis 自己列得很清楚:
Rubin NVL72 從 preview 轉為正式結果
AMD MI455X UALoE72 機櫃測試,AMD 已同意在自家機房開放(口頭)
TPUv8i(原生 FP4)約 6 個月內納入(口頭)
SambaNova SN50、Amazon Trainium3 列入計畫,目前沒有結果
AMD 機櫃級產品的背景,可參考 法說精華:AMD|Q2 FY2026(Helios)。
6. 風險與反面論點
Rubin 數字是 preview:預發布軟體、全口徑功耗是 SemiAnalysis 模型推估,正式結果出來前,7.19 倍只能當上限參考。
TCO 假設決定排名:每小時成本採 hyperscaler 規模自持,TPU 還有內部與外部兩套 TCO。租用價格或小規模部署,結論可能不同。
64% 只代表 OpenAI 企業版:這是單一公司、單一客群的輸出 token 占比,不能直接推到整個推論市場。
口頭數字未經驗證:70% 毛利、Jalapeno 全曲線勝出、Bedrock 與 Fireworks 的規模,投影片上都沒有出處。
跑分有贊助生態:InferenceX 由硬體商、模型商與 hyperscaler 捐贈硬體與程式碼。方法與 CI 公開是優點,但測試優先順序仍受合作關係影響。
7. 對台灣供應鏈的意義
晶圓代工不受「誰贏跑分」影響。圖上互相競爭的 NVIDIA、AMD、Google TPU 加速器都在台積電生產,份額在三家之間移動,對台積電的先進製程與先進封裝需求影響有限。真正的變數是總量,而 agentic 流量的成長正在推高總量。
單顆晶片功耗從 2.12 kW 升到 3.3 kW,代表每顆加速器需要更多的電源轉換與散熱能力。台灣的機櫃組裝、電源與液冷供應鏈,單位晶片的價值量會跟著功耗上升;但這場演講沒有點名任何台廠,個別公司的受惠程度要看各自的客戶與產品組合。
光通訊這次沒有被提到,但這正是重點。當機房以每 MW token 計價,光模組與 CPO 的 pJ/bit 主張,最終要換算成「省下的電能多產出多少 token」才有說服力。互連的能耗基準可參考 OIF 替 AI 互連畫了張官方地圖。
長 context 推高記憶體需求。CPU KV offload 帶來 81.7% 吞吐量提升,代表伺服器端的記憶體容量配置會成為推論效能的一部分,這是伺服器板卡與記憶體模組廠值得追蹤的方向。
8. 總結
這場演講的意義在於 SemiAnalysis 把 AI 基建的計分方式從晶片規格改成服務產出:每 MW、每 1 美元、在指定互動速度下能交出多少 token。照這套算法,Rubin 的價值集中在 150 tok/s/user 附近,AMD 與 TPU 各自在特定區段勝出,軟體堆疊的影響和晶片一樣大。
時間要分開看。需求端已經發生:agentic 在 OpenAI 企業版占 64%,context 中位數 88K。供給端還在驗證:Rubin 正式結果、MI455X 機櫃、TPUv8i 預計在未來 6 到 12 個月陸續公布。接下來該觀察三件事:Rubin 正式數字能否守住 150 tok/s 的 7 倍差距、AMD 與 TPU 在 AgentX 長 context 測試中的表現、推論服務市場是否向大型業者整併。
當計分單位變成每 MW 的 token,所有硬體爭論都會被重新定價,包括光互連。
本文僅供技術與產業趨勢分析,不構成任何投資建議。


留言