


ECOC2026 | 1.6T 只剩 4 年衝到千萬台:Lumentum 攤開量產帳本——模組 49% 的電在 DSP,而 DSP 裡只有 24% 在做運算
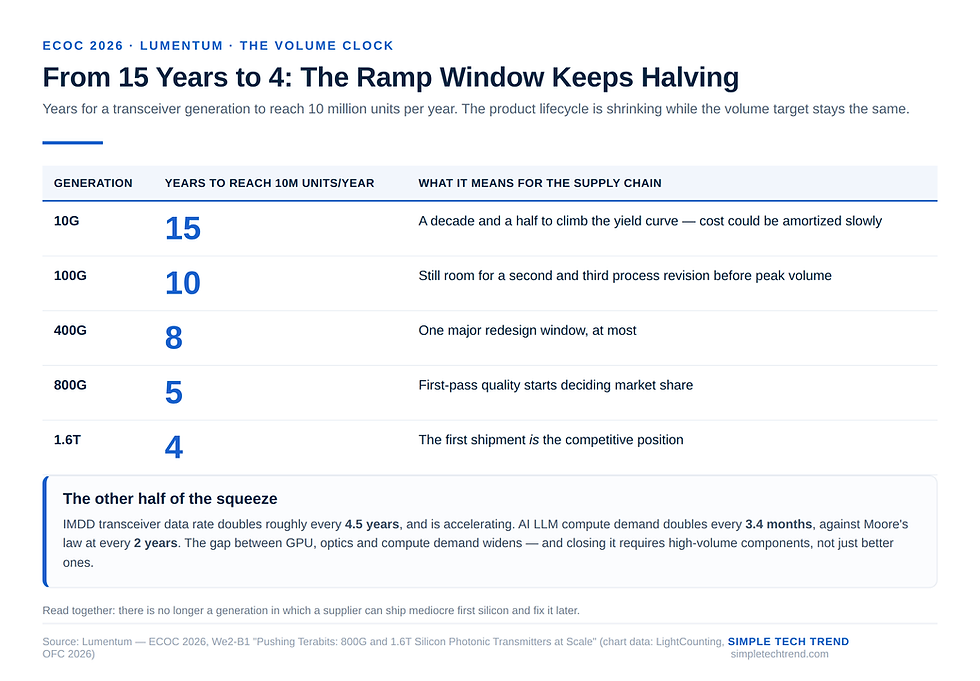
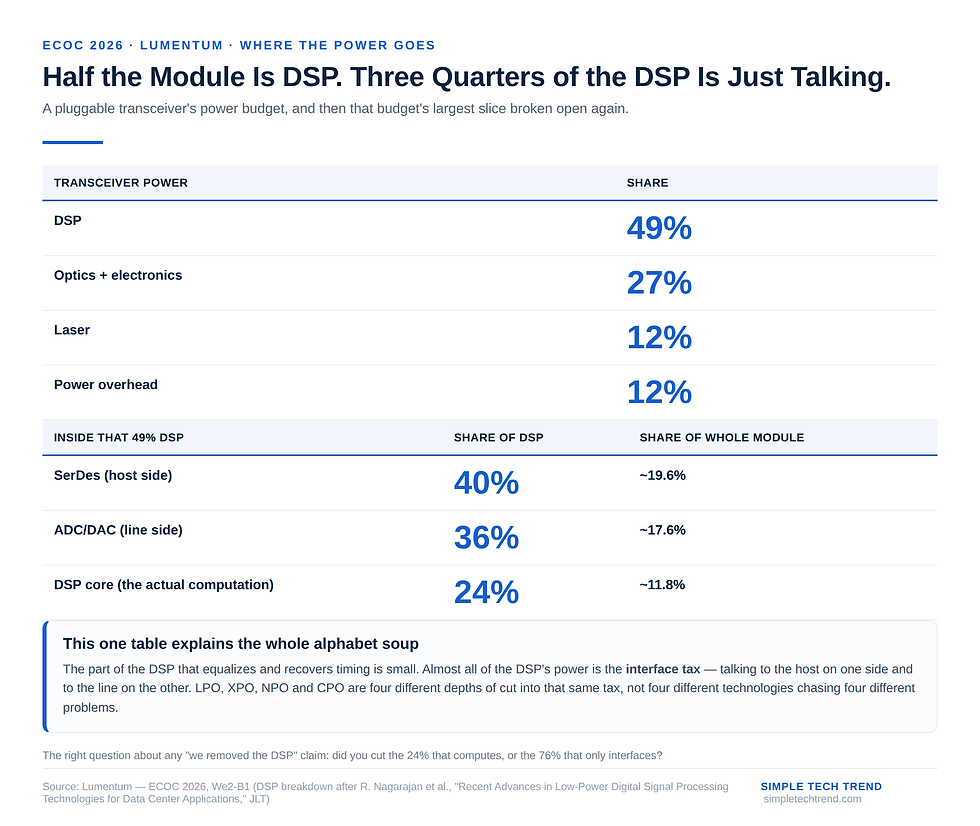
這是一場把「為什麼這一代不一樣」量化到位的演講。Lumentum 的 Erman Timurdogan 丟了兩組數字:第一組是從 10G 到 1.6T,一個速率從發表到年出貨一千萬台所需的時間,從 15 年壓縮到 4 年;第二組是一顆可插拔模組的功耗裡,DSP 佔 49%,而 DSP 內部真正在做運算的核心只佔 24%,其餘 76% 是 SerDes(40%)與 ADC/DAC(36%)——純粹在跟外面講話。 這兩個數字合起來就是整個 LPO/XPO/NPO/CPO 浪潮的全部動機。而他給的下一代目標也很硬:LPO/XPO/NPO 要打 <10 pJ/bit,switch radix 從 512 長到 1024(200G/lane);CPO 要打 <5 pJ/bit,走慢而寬,radix 上看 4096(50G/lane)。 整場最實用的一段反而不在效能,而在測試——他直說,光學的自動化功能測試瓶頸是「插光纖、清光纖」這種事。
1. 那張「達到千萬台要幾年」的圖,是這場最該被抄走的一張
演講開場先鋪了兩層宏觀。第一層是算力:投影片引 OpenAI 的 AI and Compute 研究,摩爾定律是每兩年翻倍,而 AI LLM 的算力需求是每 3.4 個月翻倍;旁邊那張 Kaplan 的 scaling law 曲線(L = 2.57·C^−0.048)補上一句「算力會改善 AI 輸出的準確度」——也就是說這個需求不會自己停下來。
第二層才是重點。橫軸是速率世代,縱軸是「從這個速率開始出貨,到年出貨量達到一千萬台,花了幾年」:
10G:達到 1,000 萬台/年所需年數 15 年
100G:達到 1,000 萬台/年所需年數 10 年
400G:達到 1,000 萬台/年所需年數 8 年
800G:達到 1,000 萬台/年所需年數 5 年
1.6T:達到 1,000 萬台/年所需年數 4 年
而同一張投影片的左圖顯示,IMDD 光模組的資料速率大約每 4.5 年翻一倍,而且還在加速。
這兩件事疊在一起的意思很明確:產品生命週期在縮短,但量在同一時間內要衝更高。 投影片的結論句寫得很直白——GPU、光學與算力需求之間的落差正在擴大,而填補這個落差需要的是高量產的元件。
這對供應鏈是一個結構性的壓力轉移:過去一個世代你有十年可以慢慢把良率爬上來、把成本攤掉;現在只有四年。第一批出貨的品質,幾乎就是你這個世代的全部競爭力。
2. 模組的電花在哪裡:一半在 DSP,而 DSP 裡四分之三只是在跟外面講話
接著他拆了一顆可插拔模組。左邊是實體拆解——circulator、mux/demux、laser、DSP;右邊兩個圓餅圖才是這場的核心資訊。
第一個圓餅:整顆收發器的功耗分配。
DSP:佔比 49%
光學+電子(Optics + electronics):佔比 27%
雷射(Laser):佔比 12%
電源開銷(Power overhead):佔比 12%
第二個圓餅:把那 49% 的 DSP 再拆開。
SerDes(host 側):佔比 40%
ADC/DAC(line 側):佔比 36%
DSP 核心(做運算的部分):佔比 24%
講者在台上講這段時的意思很清楚:DSP 真正在做等化、做時序回復的那個核心,其實很小。整顆 DSP 絕大部分的電,是花在「與外界的介面」——host 側的 SerDes 與 line 側的 ADC/DAC。
把兩張圓餅乘起來:SerDes 約佔整顆模組的 19.6%,ADC/DAC 約佔 17.6%,而真正在運算的 DSP 核心只佔整顆模組的 11.8%。
這個拆解就是 LPO、XPO、NPO、CPO 這四個字母湯的全部理由。每一種方案在做的事,本質上都是同一件——把那個「介面稅」砍掉一部分。 LPO 拿掉 DSP、XPO 與 NPO 把光學往 ASIC 旁邊搬、CPO 直接共封裝。差別只在砍的位置與砍的深度。
這也呼應了我們在 ECOC2026 | 快窄與慢寬吵了三小時,沒有人先定義「慢」:這場辯論真正的分水嶺是 448G 整理過的那場辯論——大家吵的 pJ/bit 數字差到五十四倍,很大一部分就是因為「這個介面稅算不算在裡面」沒有共識。
3. 那顆 800G–1.6T DR8 的 PIC,只有四種元件
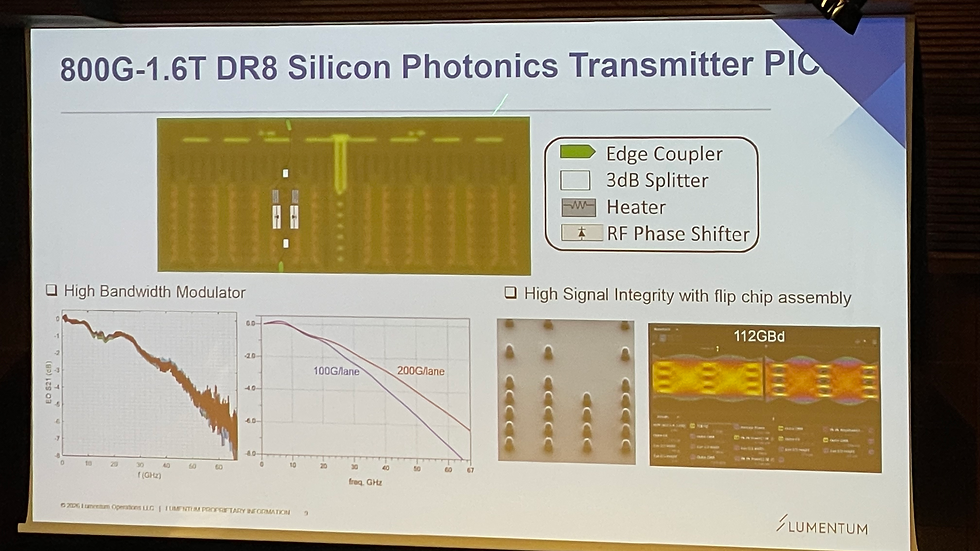
接下來他放了在產的 800G–1.6T DR8 矽光子發射端 PIC 的佈局圖,而整顆晶片的圖例只有四項:邊緣耦合器(Edge Coupler)、3 dB 分光器、加熱器(Heater)、RF 相位移器。
這個「簡單」是刻意的。一個 InP 雷射從邊緣耦合進來,經 3 dB 分光器切成兩路,兩路各自被 RF 相位移器調變,再干涉回來形成 IMDD 所需要的振幅調變——就是一個馬赫-曾德。整顆晶片沒有微環、沒有可調濾波器、沒有需要鎖定的共振腔。
效能上他給了兩個佐證:
調變器頻寬:EO S21 曲線顯示到 60 GHz 附近仍在可用範圍,而右邊那張圖把 100G/lane 與 200G/lane 的通道響應疊在一起比較——到 67 GHz 時 200G/lane 的曲線明顯比 100G/lane 平坦,意思是設計已經為 200G/lane 留了餘裕。
訊號完整性:覆晶(flip chip)組裝的凸塊陣列照片,旁邊掛著 112 GBd 的眼圖。
這裡值得台廠注意的是選擇本身:Lumentum 在 1.6T 這一代押的是「簡單結構 + 覆晶封裝」,而不是「複雜結構 + 高階演算法」。 理由在下一節——因為量產的瓶頸不在效能,在變異。
4. 耦合效率:Gen1 到 Gen2 把 FAU 損耗砍半,以及 220 mW 的線性度
這是我認為整場工程含量最高的一頁。
耦合損耗的三個數字:
SSC → 雷射(雙透鏡):邊緣耦合器插入損耗 < 0.8 dB
Gen1 SSC → 光纖陣列單元(FAU):邊緣耦合器插入損耗 < 1.8 dB
Gen2 SSC → 光纖陣列單元(FAU):邊緣耦合器插入損耗 < 0.9 dB
一個世代就把 FAU 耦合損耗從 1.8 dB 砍到 0.9 dB,整整一半。 而左邊那張 1260–1360 nm 的耦合效率曲線顯示,Gen2 的量測值(約 −0.8 至 −0.9 dB/facet)不只更低,而且整條曲線平坦很多——Gen1 在 1320 nm 之後明顯劣化,Gen2 到 1360 nm 都還守得住。
投影片對這件事的註解是:效率來自可預期、無縫的介面,那才是製造餘裕的來源。 這句話的重點是「可預期」,不是「低」。
第二個數字是線性度。 右邊那張圖是晶片上的監控光偵測器讀值 vs InP 雷射輸入功率:從 0 到 220 mW 是一條直線,讀值一路線性爬到約 6.5 mA。投影片的註解寫得很清楚——「在高輸入光功率下維持線性,是減少雷射顆數的關鍵。」
這一句要翻成白話:如果晶片能吃下 220 mW 而不飽和、不失真,你就可以用一顆雷射餵更多通道,而不是每個通道配一顆。 雷射佔了模組 12% 的功耗,更佔了相當比例的成本與可靠度風險——能少用幾顆,就是直接的競爭力。 這一點跟 ECOC 同一屆光源 workshop 的結論完全對得上,我們整理在 ECOC2026 | 資料中心要幾十億顆雷射,卡住的卻是「接上去」那 5 分鐘。
再往下一頁是晶圓地圖:典型 1.6T DR8 的晶圓級測試,全片損耗變異 < 0.5 dB(色階是 ±0.25 dB)。旁邊的 2×DR4 晶圓投片量從 2024 到 2025 是一條翹起來的曲線。投影片的結論句是:矽光子產品要放量,需要的是低變異的元件與晶圓級的分佈資料。
5. 量產真正卡住的地方是測試,而且卡在「插光纖」這種事
這是整場我認為最被低估、但對台廠最有用的一段。
講者在講製造挑戰時提到幾件事,都不是效能問題:光學產業大量使用環氧樹脂(epoxy)、大量依賴主動對準,這是相對 IC 製造最大的差異,也是吞吐量的上限。 可靠度驗證要做 2,000 小時甚至更久的測試,而換一個零件供應商就可能要重跑。
然後是最直白的一句:光學的自動化功能測試很花時間,而瓶頸往往是「在測試站插光纖」——清光纖、插光纖、組裝,先做結構測試再做功能測試。
Lumentum 給的解法路徑分兩步:
第一步,垂直耦合器晶圓級測試。 投影片顯示了 A–D 四個通道的分光比(tap ratio)盒鬚圖與 SiPho 整合 MUX 的晶粒級測試結果。但它也誠實標出了限制:垂直耦合器吞吐量高,但只能測單一偏振、單一通帶。 然後留了一個問號:「那同調或 CWDM 的 PIC 要怎麼測?」
第二步,下一代的晶圓級邊緣耦合測試。 這是他們的答案:利用矽光子的切割溝槽(dicing trench),讓標準 FAU 可以在晶圓階段就從邊緣耦合進去測。 投影片上是 WLT 邊緣耦合器 FAU 光學探針的照片,加上一個 FWHM > 6 µm 的模場分佈圖,右邊是六張對準熱圖。
這件事的意義是:把「必須切割、封裝完才能測」變成「晶圓上就能測」。 對一個只有四年可以從零衝到千萬台的世代,這不是效率改善,是能不能玩的前提——壞的晶粒愈早篩掉,後段那些昂貴又慢的主動對準與封裝工時才不會白花。
對台灣供應鏈,這一段是最實際的落點:這裡的機會不在矽光子本身,在探針卡、FAU 光學探針、晶圓級對準治具、以及能處理切割溝槽的切割與檢測設備。 這些都不是磊晶或晶圓廠的生意,是設備與精密結構件的生意。
6. 下一代的兩條數字線:<10 pJ/bit 與 <5 pJ/bit
最後一段回到路線圖,而這張圖給了非常清楚的座標。
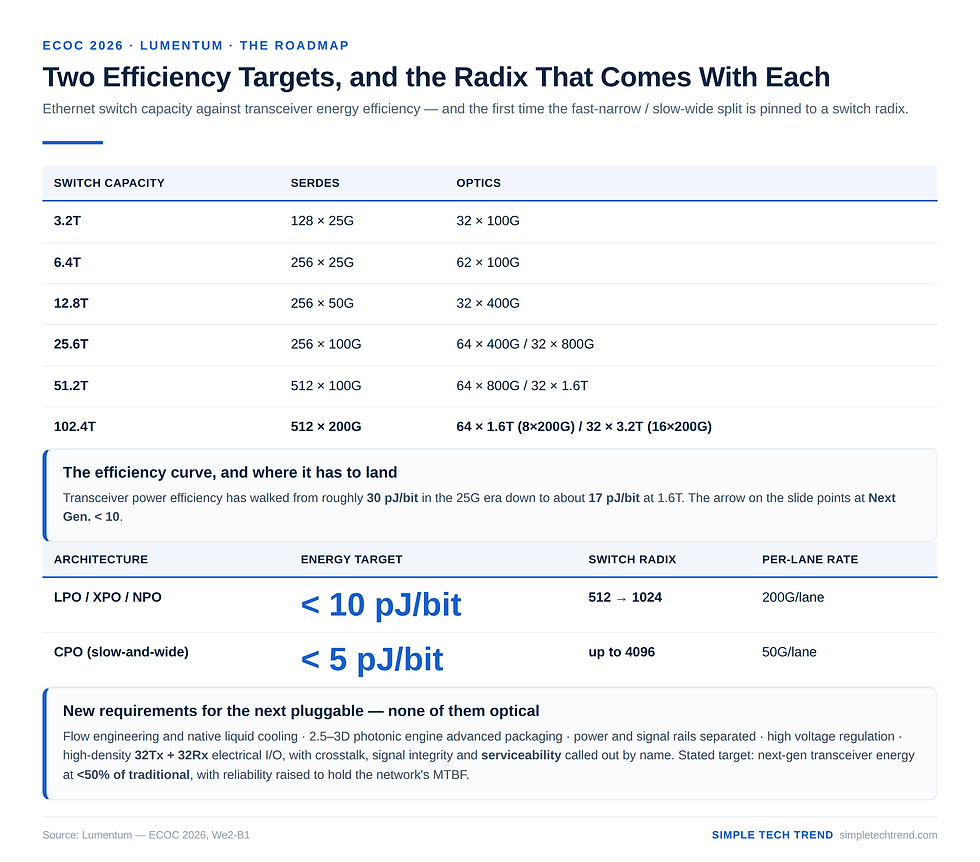
左邊是一張雙軸圖:Ethernet 交換容量(3.2T 一路到 102.4T)對上光收發器能效(pJ/bit),時間軸從 2016 到 2026。能效曲線從約 30 pJ/bit 一路下到 17 pJ/bit,而箭頭指向「Next Gen. < 10」。
容量的每一階都標了對應的 SerDes 與光學配置,值得抄下來:
3.2T:SerDes 配置 128 × 25G;光學配置 32 × 100G
6.4T:SerDes 配置 256 × 25G;光學配置 62 × 100G
12.8T:SerDes 配置 256 × 50G;光學配置 32 × 400G
25.6T:SerDes 配置 256 × 100G;光學配置 64 × 400G/32 × 800G
51.2T:SerDes 配置 512 × 100G;光學配置 64 × 800G/32 × 1.6T
102.4T:SerDes 配置 512 × 200G;光學配置 64 × 1.6T(8×200G)/32 × 3.2T(16×200G)
而下面兩行結論才是真正的判斷:
LPO、XPO 與 NPO 目標 <10 pJ/bit,而 switch radix 從 512 成長到 1024(200G/lane)。
CPO 目標 <5 pJ/bit,走慢而寬(slow-wide)路線,潛在 switch radix 上看 4096(50G/lane)。
這兩行把「快而窄 vs 慢而寬」這把尺,第一次跟 switch radix 綁在了一起。 1024 lane 的 200G/lane 與 4096 lane 的 50G/lane,總頻寬是同一個數量級,但封裝、岸線、電源與可靠度的難度完全不同。這正是 ECOC 這一屆各家真正在吵的東西——我們在 銅纜撐不住 AI 之後:scale-up 光互連的七條路,與各撞一堵牆的兩種活法 拆過這把尺的完整結構。
而講者對下一代可插拔模組列的新需求清單,也全部是系統級的,沒有一項是「光學做更好」:流道工程與原生液冷、2.5–3D 光子引擎的先進封裝、電源與訊號軌分離、高壓調壓、以及 32Tx+32Rx 的高密度電氣 I/O(串擾、訊號完整性、可維修性)。
注意最後那個詞:可維修性(serviceability)。 這跟 Huawei 在同一屆把「可維修」排在「省電」前面是同一個訊號——當模組密度高到這個程度,能不能修,變成跟省多少電一樣重要的規格。
結論投影片上還有一句很硬的目標:下一代收發器(XPO/NPO/CPO)的能耗目標是傳統方案的 <50%,而且為了維持新網路的 MTBF,可靠度必須提升。
7. 總結
把這場放進 ECOC 2026 的脈絡,Lumentum 的位置很特別:別人在講「應該走哪條路」,它在講「不管走哪條路,你都得先過量產這一關」。
對台灣供應鏈,三個具體落點:
第一,那張「4 年」的圖應該貼在會議室牆上。 它改變的不是技術路線,是專案排程的基本假設。過去「先出樣品、再慢慢爬良率、第三年開始賺錢」的節奏,在 1.6T 這一代已經不成立——四年後這個世代就要滿產,而下一代已經在敲門。 誰的第一批就是高良率、低變異,誰就吃得到這四年。
第二,那個 49%/24% 的拆解,是評估任何「去 DSP」方案的正確分母。 當有人說某方案省了多少電,第一個該問的是:你砍的是 DSP 核心那 24%,還是 SerDes 加 ADC/DAC 那 76%? 砍前者幾乎沒有意義,砍後者才是真的。這也是為什麼 CPO 敢喊 <5 pJ/bit 而 LPO/XPO/NPO 只敢喊 <10——砍的深度不同。
第三,也是最被低估的——測試設備與治具是這一輪的隱形機會。 講者親口說瓶頸是「插光纖、清光纖」,而他們的解法是把 FAU 光學探針搬到晶圓上、利用切割溝槽做邊緣耦合測試。這是一個標準還沒定、玩家還很少、而需求由四年的時間壓力硬逼出來的位置。 對台廠而言,這比再去擠一個矽光子晶片設計的位子,門檻更低、時間窗更明確。
宣判:這場演講沒有宣布任何新技術,但它把 1.6T 這一代的難度從「做不做得出來」重新定義成「四年內能不能做出一千萬顆一樣好的」。當 DSP 核心只佔模組功耗的 12%、當 FAU 耦合損耗一個世代砍半、當測試瓶頸是插光纖——這些都在說同一件事:矽光子的競爭已經不是光學競爭,是製造競爭。而製造競爭,正好是台灣供應鏈最該聽懂的那一種。
本文僅供技術與產業趨勢分析,不構成任何投資建議。
相關閱讀
ECOC2026 | 快窄與慢寬吵了三小時,沒有人先定義「慢」:這場辯論真正的分水嶺是 448G:同一屆的路線辯論,以及為什麼大家報的 pJ/bit 會差到五十四倍
ECOC2026 | 資料中心要幾十億顆雷射,卡住的卻是「接上去」那 5 分鐘:光源與封裝對準的產能瓶頸,與本文「減少雷射顆數」的動機互為表裡


留言