


2026 OCP Global Summit | Lumentum | Oleg Shchekin | Slow and Wide 12.8T VCSEL Solutions
1. 8 分鐘的平台說明:Lumentum 賣的是一塊積木
這個場次的名稱是「Slow and Wide 12.8T VCSEL solutions」,議程另列了 Eliyan 執行長 Ramin Farjadrad 與 Coherent 的 Chris Kocot,但官方簡報與錄影只涵蓋 Lumentum 這一段,簡報標題是「VCSEL-based High Density Interconnects」,本文只拆 Lumentum 的部分。Shchekin 整場只有一個主張:一顆 1060 nm VCSEL 陣列,可以從可插拔一路用到 CPO。
投影片列了七個賣點:可擴展架構、高頻寬密度、高能效、沿用既有組裝方法、沿用既有光纖與連接器生態系、可靠度、高量產能力,旁邊還特別標了「3D Sensing Supply chain」。這張表裡最有份量的其實是後半段:它要說服的不是工程師,而是採購與製造。
可靠度部分,投影片給的是 1060 nm VCSEL 的 HTOL 數據:8 mA、烘箱 115°C,接面溫度達 181°C,跑到 5,000 小時,閾值電流、輸出功率與電壓的漂移曲線都幾乎是平的,口頭補充沒有任何失效。這組數據與 850 nm 的對比,我們在 ECOC2026|850nm 撐 1,600 小時就全掛,1060nm 跑到 5,000 小時零失效 已經拆過,這裡不重複。這次 OCP 的新東西,是把同一顆元件放進一張完整的產品地圖。
2. 拆解 1060 nm:為什麼是覆晶背出光
Shchekin 花最多時間講的是元件結構。Lumentum 的 VCSEL 陣列是覆晶(flip-chip),光從基板背面射出,基板背面直接蝕刻微透鏡陣列,用來改善光纖耦合。
覆晶的好處是所有電接點都在貼合面上,光學面完全獨立:
可以加通道、拉開間距、做得更密,或改變陣列形狀,光學端都不受影響。
頂部出光(top-emitting)架構要打線,通道一多就有打線與特性量測的問題。
關鍵在波長。850 nm 做不到背出光,因為砷化鎵基板會吸收 850 nm 的光;1060 nm 可以穿透。同樣的邏輯延伸到接收端:1060 nm 的光偵測器陣列也能做成覆晶,基板可以選磷化銦、砷化鎵,某種程度上甚至可以用矽。
簡單的說:1060 nm 不只是比較耐熱,它讓發射端與接收端可以用同一套覆晶架構、同一種組裝流程。這是 850 nm 多模生態系換不過來的地方,也是 Lumentum 把整個平台押在 1060 nm 的原因,相關比較可參考 850 nm 不是輸在速度,是輸在接面溫度。
3. 從 1.6T 到 12.8T:同一顆陣列排 16 次
整場最重要的是「Scalable Architecture」這張表。
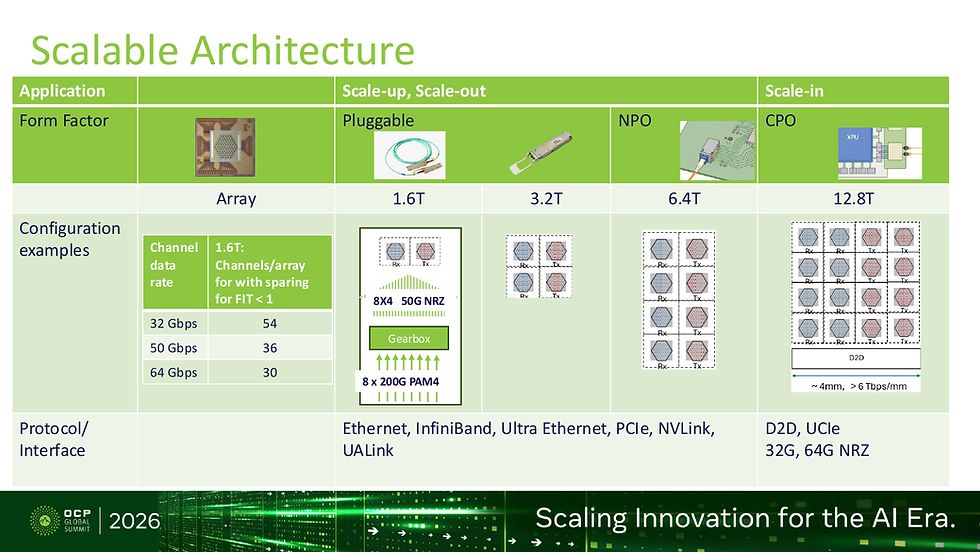
▲ Lumentum 以同一顆 1060 nm VCSEL 陣列組出 1.6T、3.2T 可插拔、6.4T NPO 與 12.8T CPO,並列出不同通道速率下的備援通道數(圖片來源:Lumentum|2026 OCP Global Summit 簡報(第 3 頁))
規格 | 封裝 | 陣列數(Tx+Rx) | 應用 | 電介面 |
1.6T | 可插拔 | 2 | Scale-up/Scale-out | 8×200G PAM4 經 gearbox 轉 32×50G NRZ |
3.2T | 可插拔 | 4 | Scale-up/Scale-out | 乙太網、InfiniBand、UEC、PCIe、NVLink、UALink |
6.4T | NPO | 8 | Scale-up/Scale-out | 同上 |
12.8T | CPO | 16 | Scale-in | D2D、UCIe,32G/64G NRZ |
陣列數為 STT 依投影片示意圖計數。12.8T 小晶片是 8 顆發射陣列加 8 顆接收陣列,寬約 4 mm,投影片標「大於 6 Tbps/mm」。STT 換算:每顆陣列對應 1.6T,16 顆陣列合計 25.6 Tb/s(單向 12.8T),除以 4 mm 約 6.4 Tb/s/mm,和投影片一致;若只算單向則只有 3.2 Tb/s/mm。最合理的解讀是這個密度數字為收發合計,但投影片沒有說明口徑。

▲ 從 1.6T 到 12.8T 只是陣列數從 2 增加到 16;1.6T 可插拔的範例需要 gearbox 把 PAM4 轉成 NRZ,12.8T scale-in 的電側原生就是 NRZ(圖片來源:Simple Tech Trend 自製,資料來源 Lumentum 2026 OCP Global Summit 簡報)
這張表要看清楚電介面那一列。1.6T 可插拔要先經過 gearbox,把交換器送出的 8 條 200G PAM4 拆成 32 條 50G NRZ 給 VCSEL;而 12.8T scale-in 直接吃 D2D/UCIe 的 32G 或 64G NRZ,不需要轉換。慢而寬的能效優勢來自「光與電都跑低速、免 DSP」,一旦中間插進 gearbox,省下的電就會被吃掉一部分,投影片沒有給這顆 gearbox 的功耗。
4. 拆解備援:速度越快,備援越貴
表格左邊那一小格最容易被忽略:1.6T 陣列在 FIT 小於 1 的條件下,含備援需要多少通道。投影片給的是 32G 要 54 個、50G 要 36 個、64G 要 30 個。
STT 把它拆成「實際需要」與「備援」兩部分:
通道速率 | 1.6T 所需通道 | 含備援通道 | 備援數 | 備援比例 |
32 Gbps | 50 | 54 | 4 | 8% |
50 Gbps | 32 | 36 | 4 | 12.5% |
64 Gbps | 25 | 30 | 5 | 20% |
所需通道為 1.6T 除以單通道速率,備援數與比例為 STT 換算。

▲ 單通道速率從 32G 提高到 64G,所需通道從 50 降到 25,但備援比例從 8% 升到 20%;頻寬密度從目前約 1 Tb/s/mm 到 12.8T 配置的 6 Tb/s/mm 以上,口徑一致時約有 6 倍差距(圖片來源:Simple Tech Trend 自製,資料來源 Lumentum 2026 OCP Global Summit 簡報)
這組數字透露一件事:速度越快,通道越少,但每條通道越需要備援。講者沒有解釋原因。STT 的推論是:通道數減半、備援數卻沒有跟著減少,代表單一元件在高速下的失效率較高(電流密度與應力較大),需要相對更多備援才能把整顆陣列壓回 FIT 小於 1。這也代表慢而寬的可靠度,不是靠單顆 VCSEL 不壞,而是靠陣列裡多做幾顆。
5. 證據在哪:1 Tb/s/mm 的 PCIe 5 展示
封裝部分,Lumentum 給了兩條整合 CMOS 的路:
晶圓級扇出封裝(WLFOP):把標準的 VCSEL、PD、驅動器與 TIA 模塑在同一平面,背面再做重布線層(RDL),上面加散熱片。講者稱這項技術三週前在 ECOC 獲獎。
3D 堆疊:PD 與 VCSEL 直接凸塊接合到含 PHY、TIA、CDR 與驅動器的 ASIC 上。

▲ Lumentum 的兩種 CMOS 整合方式:晶圓級扇出封裝(WLFOP)與 VCSEL/PD 3D 堆疊在 ASIC 上(圖片來源:Lumentum|2026 OCP Global Summit 簡報(第 4 頁))
因為每個元件跑 32–64G,陣列間距不需要很激進,Shchekin 強調用銅柱或熱壓接合就夠,不必用混合鍵合。
可驗證的實體是和 Astera Labs、Corning 合作的光學 PCIe 展示:
1060 nm 3D FOWLP VCSEL/PD 收發光引擎,搭配 Astera Labs 的 Scorpio PCIe 交換器,放在同一個類似 NPO/CPO 的機架托盤裡
多條 32 Gb/s NRZ 通道,在 Corning 的 OM3 多模光纖上跑 PCIe 5.0 無誤碼;方案定位是多模光纖數十公尺的距離
頻寬密度目前約 1 Tb/s/mm,看得到的下一步約 4 Tb/s/mm;光引擎有路徑做到 2.5 pJ/bit 以下(投影片用語是 path to,屬目標)

▲ Lumentum、Astera Labs、Corning 光學 PCIe 機架級展示:1060 nm VCSEL/PD 光引擎、Scorpio PCIe 交換器、OM3 多模光纖(圖片來源:Lumentum|2026 OCP Global Summit 簡報(第 5 頁))
把它和第 3 節的表放在一起:展示是 1 Tb/s/mm、32G,12.8T 配置是 6 Tb/s/mm 以上、64G,若兩者密度口徑一致,中間差了約 6 倍,而 Lumentum 自己寫的「看得到的目標」是 4 Tb/s/mm。
6. 風險與反面論點
12.8T 是配置示意,不是產品。投影片沒有時程,也沒有 12.8T 的功耗或良率數字;現場能驗證的只有 PCIe 5 等級的展示。
gearbox 的功耗沒攤開。乙太網可插拔要做 PAM4 到 NRZ 的轉換,這顆晶片的功耗與延遲沒有公開,慢而寬在這一欄的能效優勢無法驗證。
pJ/bit 沒有統一邊界。2.5 pJ/bit 以下是光引擎的目標路徑,不是實測值,而且只算光引擎;Lumentum 在行動呼籲裡自己要求業界定義系統邊界,代表各家數字目前不能直接比。
光纖數量仍是挑戰。STT 估算:12.8T 以 64G 計,每個方向約 200 條有效通道,若一條通道一芯光纖,一顆小晶片就要約 400 芯。NVIDIA 在 ECOC 的 VCSEL 回顧也把慢而寬的主要瓶頸指向光纖,見 ECOC2026|VCSEL 早就打到 ≤1 pJ/bit,卡住它的是光纖。「沿用既有光纖與連接器生態系」講的是元件,不是芯數。
密度還不到 hyperscaler 的目標。Microsoft 在 ECOC 開出的光 I/O 目標是大於 10 Tbps/mm(見 ECOC2026|Microsoft 把光 I/O 的規格表寫出來了),Lumentum 的 12.8T 配置約為六成,目前方案約為十分之一;但各家密度口徑(單向或收發合計)未統一,只能當量級比較。
7. 對台灣供應鏈的意義
這場演講沒有提到任何台廠。點名的合作夥伴只有 Astera Labs(PCIe 交換器)與 Corning(多模光纖),Lumentum 本身有自有的 VCSEL 產線。
「沿用 3D 感測供應鏈」是對台灣砷化鎵產業最直接的訊號。台灣在 3D 感測 VCSEL 的砷化鎵磊晶與晶圓代工已有量產經驗;但這場講的「3D 感測供應鏈」指的是 Lumentum 自己的量產平台,沒有提到外部代工,1060 nm 的磊晶結構也與 850 nm 不同。台廠能否切入要看 Lumentum 是否釋出外部產能,目前沒有公開資訊。
封裝路線對台灣 OSAT 友善。晶圓級扇出、銅柱與熱壓接合都是台灣封測業成熟的製程,Lumentum 刻意避開混合鍵合,等於把門檻放在一般 OSAT 做得到的位置。值得追蹤的是誰拿到 WLFOP 光引擎的代工。
多模光纖與連接器要看芯數。若慢而寬真的放大到每顆小晶片數百芯,高芯數多模跳線與連接器組裝會是新的產值,但這場沒有給光纖架構細節。
8. 總結
Lumentum 的慢而寬策略很清楚:不追最快的單通道,而是把一顆 1060 nm 覆晶 VCSEL 陣列做成積木,用陣列數量換頻寬,用備援換可靠度,用既有封裝換量產。12.8T 只是同一顆陣列排 16 次。
時間要分開看。今天能驗證的是 PCIe 5、32G、約 1 Tb/s/mm 的展示;4 Tb/s/mm 是 Lumentum 自己說看得到的下一步;12.8T、6 Tb/s/mm 以上的 scale-in CPO 還是一張配置圖。我們的判斷是,VCSEL 慢而寬的第一個量產落點會是電側原生 NRZ、且已有實機展示的 PCIe 光互連,而不是要加 gearbox 的乙太網可插拔;scale-in 電介面最契合,但要等 64G NRZ 與 12.8T 小晶片落地,會排在 PCIe 之後。這個判斷若錯,訊號會是 Lumentum 先公布 1.6T 可插拔的客戶與 gearbox 功耗。接下來 12 個月該觀察三件事:64G NRZ、約 4 Tb/s/mm 的光引擎何時有實測數據;可插拔版本的 gearbox 功耗是否公開;系統邊界一致的 pJ/bit 定義何時成形。
慢而寬比的不是誰的 VCSEL 最快,而是誰能用最普通的封裝,把同一顆陣列複製最多次。
本文僅供技術與產業趨勢分析,不構成任何投資建議。


留言