


站在光裡:CIOE 2026 芯·光論壇十一場全解讀,NPO 為什麼不再是過渡方案- 投影片在文末
已更新:11小时前
2026 年 9 月 9 日,深圳 CIOE 現場的「芯·光論壇」擠到走道站滿人。十一場演講從華為、騰訊、美團的需求側,一路講到海思、Marvell、華工正源、Lumentum、長飛的供給側。如果把這十一份投影片疊在一起看,會發現它們其實在回答同一個問題的三個層次:
物理上,224G/lane 之後銅纜只剩一公尺,超節點要往跨機櫃、跨樓層長,就只能換光。系統上,晶片算力以邊長平方成長、互連出口只能以邊長成長,這道剪刀差逼著光互連從「面板可插拔」往「板載」甚至「晶片旁」移。產業上——這一層才是這場論壇真正的分歧點——中國缺高階 DSP 與交換晶片,而 NPO 剛好是唯一一條「開放解耦、沿用現有供應鏈、又能立刻上 224G」的路。
於是整場論壇最強烈的一個共識浮出來了:NPO 已經不是「CPO 之前的過渡方案」,它被重新定義成與 CPO 長期並存的持久形態。美團的投影片上直接寫著「NPO 從過渡方案向長期技術路線演進」;華工正源給的判詞是「NPO 覆蓋主流,CPO 突破高端,長期分層共存」;騰訊已經把 3.2T NPO 的量產時程排到 2027 Q1。
但這場論壇值得寫的地方,恰恰在於它沒有把不同意的聲音抹掉。新華三站上台第一句話就是「電為根基」,並且指出 NPO「該省的一點都沒省掉」,CPO 才是 448G 之後的唯一解;Marvell 拿出五年出貨預測說「可插拔仍是主流,NPO 是疊加不是取代」;華工正源則另外端出 XPO 這條「可插拔再撐一代」的第三條路。
這篇文章把十一場講完整,硬數字全部以現場投影片為準。最後一節是 STT 的判斷。

1. 開場:三個數字定住了整場論壇的溫度
論壇由海思光電與 LightCounting 共同舉辦,LightCounting 的曹麗開場。她放的第一張圖不是技術,是錢。
過去十年,北美四大雲端服務商(CSP)的資本支出年增率每次衝高之後幾季就回落,唯獨這一次——從 2023 Q4 到現在,連續十二個季度維持 60% 以上的年增率,而乙太網光收發器的銷售成長甚至跑在資本支出前面。同一張圖上疊著 LightCounting 今年三次上修的乙太網光模組市場預測:一月版、四月版、七月版,每一版都往上抬,2031 年的市場規模從約 490 億美元一路上修到約 740 億美元。
美團毛明旺後來引用的是同一份資料的文字結論:2026 年乙太網光模組銷售成長將超過 70%,2031 年市場規模達 800 億美元。曹麗當場補了一句:九月底還會再更新一次。
第二個數字來自華為計算研發部的任超致辭。他在台上直接把一個過去不公開的數字解密了:一個 384 卡超節點,用掉的光模組數量是 384 × 7 × 2。這個乘法算出來是 5,376 顆——而長飛張磊的投影片給的實際交付數字更精確:昇騰 384 超節點用了 384 顆 NPU、3,168 根光纖、總長 316 公里、6,912 個星雲光模組,實現 NPU 全 MESH 互連。
任超講這段的脈絡很誠實:華為 2023 年決定做 384 超節點時,「所有人都沒有特別有信心」,因為國內晶片產業面臨的最大問題就是缺晶片、工藝不行,只能用超節點這種方式堆出大算力。而要把這麼多晶片連起來,電的擴展性撐不住,最後只能全部走光。他也明講了下一步:從 384 到 1K 到 8K,連接也都是光。
第三組數字來自華為吳雙起的投影片,那是整場論壇裡最完整的一張「錢流圖」:
2025 年全球 AI 資料中心投資超過 5,000 億美元:微軟 800 億、Amazon 1,500 億、Meta 600 億、Google 750 億、Stargate 1,000 億、X.AI 120 億
2026 年上半年,NVIDIA 光是在光互連領域就投了 超過 100 億美元:Lumentum 20 億、Coherent 20 億、Marvell 20 億
Google 的月處理 Token 量從 2024 年 5 月的 9.7 兆,到 2025 年 5 月約 480 兆,再到 2026 年 5 月突破 3,200 兆——兩年增長超過 300 倍
2026 年全球 800G 以上光模組需求 超過 1 億只
這三組數字擺在一起,論壇的基調就定了:這不是一場討論「光互連有沒有機會」的會,而是一場討論「用哪一種光互連、什麼時候上」的會。
2. 華為吳雙起:224G 是銅纜的物理終點線
華為雲與計算硬體部的吳雙起,開場第一句話是「我到華為也有二十幾年,一直在做光」。他的投影片標題叫〈超節點互連需求與挑戰〉,講的是需求側最硬的那一塊。
銅退光進,這次不是口號
「銅退光進」這句話在光通訊圈講了十年,但這次它被量化了。
吳雙起引用華為 2012 實驗室的資料,畫了一條銅纜可達距離對速率的下降曲線:56G 約 3 公尺、112G 約 2 公尺、到了 224G 只剩 1 公尺。而在 224G、1 公尺這個點上,銅纜的插入損耗是 35 到 40 dB,已經無法維持穩定的位元錯誤率(BER)。
投影片上那句話寫得很白:224G 就是銅纜在資料中心互連中的「物理終點線」。
要往下走,銅纜只剩兩條路:加 Retimer(疊加成本),或是加粗線徑。他順手放了一張 AWG 線規表——8 AWG 的導體直徑 3.26 mm、電阻 2.061 mΩ/m;30 AWG 直徑只有 0.25 mm,電阻卻是 338.6 mΩ/m。線徑一加粗,整束線纜在機櫃裡根本沒辦法部署與維運。

800G LPO 已經把答案示範過一次
吳雙起把 800G 世代當成一個已經跑完的實驗。他直接把 800G SR8 的兩種方案並排比較:
關鍵性能 | 800G SR8 LPO | 800G SR8 oDSP |
傳輸距離 | 50m~100m | 50m~100m |
單端延遲 | 遠低於 oDSP(投影片以 x 遮蔽具體值) | 約 110 ns |
功耗 | 約 4.x~6 W | 14~17 W |
這張表的意義是:把 DSP 拿掉之後,功耗直接砍掉七成,而傳輸距離與 BER 沒有付出代價。他也提到 800G LPO 搭配 VCSEL,讓應用場景「從 50 公尺突破到 100 公尺」。
我們之前在 銅纜撐不住 AI 之後:scale-up 光互連的七條路,與各撞一堵牆的兩種活法 把這條路線的分岔拆過一遍;吳雙起這張表等於用華為自己的量產數據,把「線性直驅」這條路的第一段跑完了。
三高三低:超節點把指標全部量化
吳雙起把超節點對光互連的要求拆成「三高」與「三低」,而且每一項都給了數字目標——這是整場論壇裡最具體的一份需求書。
三高:
高可靠:可靠度指標要從現在的 500 Fit/Module @50°C 優化到 30 Fit。這是十六倍以上的改善要求。他的理由很直接:大模型訓練推理動輒數千上萬顆晶片,任何一次閃斷都會導致業務回滾、算力浪費。
高頻寬:單模組頻寬要從「往上提速」轉成「往外提頻寬」,未來透過 WDM 挑戰 單纖 800G。投影片上的截面比較很有意思:一條 1.5 mm × 0.7 mm 的 32 AWG 銅纜承載 8×224G;而單模光纖芯徑只有 8~10 μm(包層 125 μm),可以承載 8 到 36 個 224G 通道。
高密度:每 lane 佔用的面板寬度要從 2.8 mm/Lane 壓到 0.43 mm/Lane。
三低:
低延遲:DPO 的 110 ns → LPO 的 <10 ns → NPO 的 <5 ns
低功耗:DPO 的 20 pJ/bit → LPO 的 5 pJ/bit → NPO 的 約 3 pJ/bit。他還給了一個常被忽略的比例:網路櫃中光模組的功耗佔設備總功耗高達三分之一。
低成本:2014 年 OFC 上有人喊出「100G 模組要做到 100 美元」,當時一顆模組要 1,200 美元;2025 年 OFC 已經做到 1 美元/Gbit;下一個目標是 0.125 美元/Gbit。

光模組形態演進:2026+ 是 NPO,2030+ 才是 CPO
吳雙起最後放了一張跨越 1999 到 2030+ 的形態演進路線圖,把整條線分成三段:
面板 Module 時代:從 SFP、XENPAK、XFP 一路到 QSFP28、QSFP-DD、OSFP,搭配 112G SerDes
在板 Optics 時代(2026+):NPO,搭配 224G SerDes
晶片出光時代(2030+):CPO / OIO,搭配 448G SerDes,走向全光互連、光交換、光計算
這張圖上有一個紅字:「跨越」——標在面板與在板之間。華為的判斷是,2026 年這一跳不是漸進的,是斷裂式的。
3. 騰訊姜志濱:問題已經不是「能不能做」,是「能不能部署」
騰訊光網路技術專家姜志濱一上台就把問題重新定義了一次:
上半年大家還在討論 NPO 能不能做,今天我想和大家交流的是 NPO 能不能部署。
這是整場論壇裡最關鍵的一次語氣轉換。從可行性問題變成工程問題,代表這家雲端業者已經做完評估、下完決心、並且把時程排進了量產日曆。
為什麼騰訊選 NPO 而不是 CPO
姜志濱給了一張四方案六維度比較表,這是整場論壇裡最乾淨的一張選型依據:
方案 | 互連規模 | 頻寬密度 | 良率與成本 | 可維護性 | 傳輸距離 |
AEC | 單/雙機櫃 | 低 | 良率高、成本低 | 插拔更換 | <5 m |
AOC | 多機櫃 | 低 | 良率高、成本適中 | 插拔更換 | <500 m~2 km |
NPO | 多機櫃 | 適中 | 良率適中、成本適中 | 設備級更換 | <500 m~2 km |
CPO | 多機櫃 | 高 | 良率低、成本高 | 不可更換 | <500 m~2 km |
結論一目瞭然:AEC 在「互連規模」這一格直接被一票否決——它只能撐單機櫃,而超節點正在從集中式(NVL144、NVL576 這種單機櫃方案)往分散式走。CPO 在頻寬密度上贏,但在良率、成本、可維護性三格全部掛紅。NPO 是唯一一個六格全綠或可接受的方案。
512 卡超節點:兩種 NPO 落地形態
騰訊的目標拓樸很明確:用 3.2T NPO 做一個 512 卡超節點的全互連。
投影片上的組網圖是這樣走的:512 顆 GPU → 電層 Shuffle → Retimer → 3.2T NPO(每組 ×4)→ 16 台 NPO 交換器(SW0 到 SW15)。鏈路速率標的是 200 Gbps、100 Gbps/lane、800 Gbps,而 NPO 交換器的容量是 102.4T。
NPO 在這套系統裡有兩種落地形態:一種是從 GPU 側做 NPO I/O 板直出,另一種是直接做 NPO 交換器。姜志濱特別提到,右側這些交換節點其實可以沿用之前 64 卡、128 卡的機櫃設計,只是把互連方式從銅換成光。

標準化已經做到「弱定制化」
被問最多的問題是:NPO 內部的光電晶片是不是要完全客製?姜志濱的答案是不需要。
騰訊的 3.2T NPO 電接口與光接口都已經標準化,內部則是解耦的:
EIC:支援 4 或 8 通道 TIA;Driver RF pitch 支援 625 μm 與 375 μm 兩種
PIC:支援 DR16 與 DR16 mirror 兩種佈局;EC pitch 支援 127 μm 與 84 μm
他的原話是「和可插拔模組沒有明顯的區分」——只是把「手指式的可插拔」換成 LGA 或 Mezzanine 式的可插拔,其他變化並不大。這也是他認為模組廠做 NPO「相對來說應該是得心應手」的原因。
矽光還是 VCSEL?騰訊給了實測數據
這是整場論壇裡少數有第一手量測比對的一頁。
眼圖:Channel 1 的 ER = 4.63 dB、TDECQ = 0.9 dB;Channel 2 的 ER = 4.65 dB、TDECQ = 1.35 dB
BER 盒鬚圖:矽光 NPO 的基準線落在 3×10⁻¹⁰,VCSEL NPO 的基準線落在 2×10⁻⁸
差了將近兩個數量級。姜志濱的解讀不是「VCSEL 不行」,而是矽光有足夠的 margin 去增強系統的魯棒性——在驗證這套系統是否成功的階段,矽光是比較好的途徑;VCSEL 未來在效能提升上仍有很大潛力。
真正的挑戰在壓合與可靠性
姜志濱花了超過三分之一的時間講兩件很不性感的事。
第一件是壓合。NPO 用 LGA 方式固定,對壓合力非常敏感。他放了一組 BER 對壓合力的實測:在 PCB 翹曲點上,5 KG 與 10 KG 兩種壓合力下的 BER 分布明顯不同;但在 PCB 正常點上,壓合力變化幾乎不影響 BER。投影片的結論寫得很直接——PCB 翹曲點受壓合力變化影響。這代表 NPO 的 EVB 設計、PCB 厚度、承接點布局全部要重來一遍。NPO 交換器目前的做法是八顆 NPO 連成一塊,用螺絲壓板固定。
第二件是可靠性推導。由於 NPO 還沒真正上線,只能從可插拔模組的失效分布往下推。投影片列出六類失效:光學髒污、元器件故障、雷射器、加工工藝(膠水)、插拔故障、光纜故障——然後逐項給出 NPO 的緩解機制:
失效類型 | NPO 的對策 |
光學髒污 | 全封閉式管殼,減少內部髒污 |
元器件故障 | 大部分控制晶片移交主機,模組保護在主機內 |
插拔故障 | 加重蓋板壓合 socket 設計(用機械固定取代手擰) |
光纜故障 | 無中板設計,減少連接器跳數 |
加工工藝故障 | 採 BGA 封裝,無膠水耦合工藝 |
雷射器故障 | 採 外置 ELS,可插拔 |
姜志濱的推論是:插拔故障原本是最大宗的失效來源,而 NPO 用機械固定取代人工插拔之後,這一類故障應該可以大幅降低;加上 NPO 模組是在設備廠內完成安裝、保護在主機之內才送到機房,運輸與生產過程的機械固定程度遠高於可插拔模組。他的結論是 NPO 的可靠性會「大大優於可插拔模組」。
但代價也寫在投影片最後一行:「無法現場可插拔,3.2T NPO 可靠性必須努力做到接近整機。」

時程表
投影片上的 Roadmap 是這樣排的:
時間 | 里程碑 |
2025 H2 | 規格制定(騰訊 3.2T NPO 規格書) |
2026 H1 | DVT |
2026 H2 | PVT |
2027 Q1 | 512 卡超節點部署 |
2027 Q2 | 可行性分析報告 |
值得一提的是,姜志濱口頭上講的是「今年底到明年初真正部署」,比投影片上的 2027 Q1 略早。以投影片為準。這套互連設備已經在 CIOE 現場展出。
4. 美團毛明旺:AI 網路的真問題不是速率,是可運維性
美團基礎設施部的毛明旺講的題目是〈AI 網路光互聯技術實踐與展望〉,但整場最有價值的部分不在速率演進,而在他把「AI Agent 工作流」對網路的衝擊講清楚了。
三個數字說明這不是線性成長
約 2.1 年:GW 級資料中心的建設週期
每年 5 倍:訓練大型語言模型所需的運算資源成長速度
每年 30 倍:大型語言模型上下文視窗的成長速度
他的推論很簡單:今天做的網路規劃,如果只按線性外推,到明年就面臨根本性重構的風險。所以光互連的驗證與技術儲備必須超前於資料中心建設。
世代演進表
美團的 DCN 世代對照是這場論壇裡最完整的一份:
世代 | SerDes | 對應互連 | Radix | 光模組 |
DCN 3.0 | 25G NRZ | 25G DAC/ACC | 128× | 100G Q28 SR4/CWDM4 |
DCN 4.0 | 50G PAM4 | 200G 1:2 DAC/ACC | 64× | 400G Q-DD SR8/FR4 |
DCN 5.0 | 112G PAM4 | 400G Q112 SR4 | 128× | 400G Q112 SR4/DR4 |
DCN 6.0 | 112G PAM4 | 800G OSFP 2×SR4 | 128× | 800G OSFP 2×DR4 |
DCN 7.0 | 224G PAM4 | 1.6T OSFP 2×SR4 | 128× | 1.6T OSFP DR8/2×FR4 |
Future | — | NPO / CPO | — | — |
現況:400G 已大規模部署、800G 批量部署中、1.6T 正在規劃中。
Agent 工作流讓網路的問題換了一種
這是毛明旺整場最有洞察的一頁。傳統 LLM 推理是「一次請求、一次回應、完成即止」;AI Agent 工作流是「持續循環、自主決策、動態執行」。兩者對網路的要求完全不同:
傳統 LLM 推理 | AI Agent 工作流 | |
執行模式 | 單次請求回應,無狀態 | 多輪循環執行,上下文持續累積 |
運算特性 | 運算密集,GPU 持續高負載 | IO 密集 + 間歇運算,等待工具時 GPU 空閒 |
KV Cache | 短暫存在,用完即釋放 | 持續增長:100K Token 對應 20~50 GB,需跨步驟持久化 |
流量特徵 | 短突發,可預測易調度 | 大小流共存:工具調用小流(KB 級)+ KV 遷移大流(GB 級),不可預測難調度 |
由此衍生的三個新挑戰,每一個都有量化的影響:
ECMP 路由失效:大流佔滿頻寬 → 工具調用延遲激增 → Agent 步驟間回應變慢
調度器與網路割裂:推理調度器只看 GPU 使用率和 KV Cache 命中率,不感知網路拓樸。結果是 KV Cache 跨 Pod 遷移產生數十 GB 的開銷、秒級到數十秒的遷移延遲
網路鏈路故障率高:單模組故障機率低,但系統規模大到故障絕對數量很高,而 Agent 長任務是小時級的,無法容忍
對應的優化方向裡,最有意思的是第三個:從「故障發生後處理」走向「提前識別和自癒」,目標是提前識別超過 90% 的開局光鏈路問題、把診斷時間壓縮到分鐘級。
eSR:把多模的距離拉回來
美團在標準上做的事是聯合 IPEC 推 eSR 系列多模標準,目標很明確——把多模光纖的傳輸距離拉長,讓它繼續留在 scale-up 場景裡。
規格 | SR(現行) | eSR(美團推的) |
400G SR8 / eSR8 | 100 m | 200 m |
800G SR8 / eSR8 | 100 m | 150 m |
1.6T SR8 | 50 m | 挑戰 100 m |
800G eSR8 在 150 公尺的實測結果是 Pre-BER < 1×10⁻¹⁰、Post-BER error free。三個技術貢獻各自被量化了:
降低 RMS 與高階模能量 → 傳輸距離提升 25%
優化封裝熱應力 → 系統效能提升 15%
優化系統非線性 → 系統效能提升 15%
這一頁把 NPO 的定位講定了
毛明旺放了一張標題叫〈NPO 已成為長期技術路線選擇〉的投影片,四段話,每一段都值得原文引用:
NPO 從過渡方案向長期技術路線演進——主流用戶均確認 NPO 的戰略定位,兼顧短期頻寬需求與研發風險控制,在開放架構、生態成熟與可控成本方面優於 CPO,正從「過渡方案」轉變為與 CPO 長期並行的重要技術路線。
224G/lane 是關鍵技術節點——光源路線上 ELS 憑藉成熟生態主導當前產業主流;調製器路線上矽光 MZM/MRM 主導規模化部署;封裝路線上 CoWoS 已成熟量產、CoPoS 處於良率爬坡期。224G/lane 是 NPO 落地的「最佳窗口」。
需要從被動運維走向主動預測——NPO 摒棄面板熱插拔之後,故障修復時間從分鐘級增至小時(天)級,故障邊界擴展為「ASIC/封裝/光引擎/機內光纖/ELS」多維耦合。
標準應考慮 224G→448G 演進——通道模擬顯示,NPO 架構相比傳統可插拔通道,PCB 走線從 5–8 英寸縮短至 2 英寸,通道裕量(COM)從 4.06 dB 提升至 5.15 dB。
而在插損這一項上,美團給了整場論壇最直觀的三段式對比(皆為 @224G):
LPO/LRO 可插拔:典型損耗 23–26 dB,四個介面損耗點
NPO:典型損耗 7–9 dB,三個介面損耗點
CPO:典型損耗 約 3 dB,一個介面損耗點
功耗上,可插拔模組約 15–20 pJ/bit,NPO 可降到 7–10 pJ/bit。
可運維性才是 NPO 真正的帳單
毛明旺誠實地把 NPO 的代價攤開:可插拔模組的 MTTR 約 0.25 小時,NPO 拿掉熱插拔之後,必須靠板卡級與系統級能力把修復效率重新拉回可控區間。他提出的三層運維體系是:
器件與光路級:採集 TX/RX 光功率、偏壓電流、電壓、溫度、BER/FEC,識別端面髒污、溫度漂移與鏈路裕量下降等早期劣化徵兆
板卡與系統級:貫通 OE、ELSFP、連接器、封裝與交換晶片,實現 Lane 級根因定位與多廠商故障定界
任務與業務級:將鏈路健康度與訓練/推理任務關聯,支援風險預警、流量調度、自動診斷與自癒
他那句收尾很到位:「每一個當前的最優解都是下一個問題的開始。」
5. 烽火邱晨:設備商的髒活,與那個「不是技術問題」的結論
烽火通信算力互聯產品線總經理邱晨是全場唯一一個把「設備商視角」講透的人。他一開場就自嘲做了快二十年通訊,過去參加展會講的都是傳輸,現在得專門成立一條「算力互聯產品線」。
從 Scale Across 到 Submarine:一張距離分級表
烽火把光互連場景拆成四層,每一層的取捨完全不同:
場景 | 距離 | 設備形態 |
Scale Across | <80 km | 可插拔相干模組 + 1U/2U 盒式設備 |
Metro DCI | 300 km | 可插拔相干模組 + 盒式/插卡設備 |
Long Haul | 2,000 km | 較大型相干模組 + 多槽位機框 |
Submarine | 10,000 km | 大型多層機框 |
邱晨的核心論點是:過去十年光傳輸在追求「單纖最大容量、最長距離」,但面向算力,需求變成了一個平衡三角——距離、功耗、成本、容量、密度、維護性,不是要兼顧,而是在不同場景裡不停地做加減法。
海纜場景下功耗不敏感、成本不敏感、體積更不重要,追求的是壓榨每一段頻譜每一米距離。但資料中心之間的 Scale Across 完全相反:這是一次性把整個波段舖滿、幾乎不做波道級調整的場景,追求的是成本夠低、佈放夠簡單。被認為已經淘汰的 AWG、TFF 這些東西,在這個場景裡又回來了。
空芯光纖與 G.652D 的實景對打
烽火在 CIOE 現場展出的是一組實測系統:兩端各 32 顆可插拔相干模組,中間分兩條路徑——空芯光纖 @50 km 與 G.652D @50 km——直接比時延與效能差異。
六項硬指標:
項目 | 數值 |
超高密度 | 25.6T @2U |
超低時延 | 167 μs @50 km |
超低功耗 | <80 W/T |
極簡部署 | One Fiber One Device |
超低色散 | ≤3 ps/(nm·km) |
超低衰耗 | C+L 0.05 dB/km |
而市場面的數字是:Scale Across 的複合年成長率超過 55%(2025→2030F),明顯高於其他相干光傳輸市場;資料中心內的 Scale Up/Out 互連市場則超過 40%。
上下文長度決定硬體迭代的回報率
這是烽火投影片上一張很少見的表,講的是「硬體升級對不同上下文長度的效能提升效率」:
上下文長度 | 硬體迭代的效能提升效率 |
8K | +20% |
128K | +110% |
1M | +80% |
這張表的意思是:在 128K 上下文這個甜蜜點,硬體升級的邊際回報最高——而 128K 正好是當前 Agent 工作流的主流上下文長度。換句話說,現在投資互連硬體的回報率正處在歷史高點。
那個「不是技術問題」的結論
邱晨講到 NPO 時,做了整場論壇裡最直白的一次產業判斷。他的投影片左右兩欄:
左欄「技術,光進銅退是必然」:
224G SerDes 的銅纜傳輸能力
單櫃功耗及連接密度限制
40% 的功耗和成本消耗在「搬數據」,而不是處理數據
低時延訴求的「大平層超節點」
右欄「競爭,以光補電是必然」:
交換晶片供應緊張和成本高昂
國內 PAM4 DSP 仍是瓶頸
底下那行結論寫著:「NPO,是國內較明確的需求交叉點。」
他在台上補的口頭版本更露骨:「這實際上不是一個技術問題,我覺得這是一個產業問題。就是現在,中美之間的競爭關係,造成了在國內⋯⋯NPO 可能不是中間一個會很快過去的一次迭代,而是在國內這個生態裡面,實實在在是技術和競爭的一個需求的交叉點。」
這是整場論壇裡把「為什麼中國供應鏈特別擁抱 NPO」講得最清楚的一段。
烽火自己的 NPO 交換器
Fengine 51.2T NPO Switch:支援 128×400G 或 64×800G 光互連
垂直整合自研 3.2T 光引擎,同時支援第三方光引擎
垂直整合保偏光纖、MPO、shuffle、連接器
使用國產 25.6T / 51.2T 交換晶片
自研 X86 控制扣板、BMC 扣板
液冷 + 風冷輔助,ASIC + OE 一體化冷板均衡技術
但邱晨誠實地說了做這件事遇到的麻煩,而且這些麻煩跟騰訊講的高度一致:十六個 OE 在一塊 PCB 板上要怎麼壓接、怎麼確保跟下面 socket 的連接有效性、不同 socket 的不同 OE 在交換晶片旁邊的 PCB 走線怎麼協調。
他還丟了一個很尖銳的量測結果:同一顆光引擎,放在國內交換體系與國外交換體系下,BER 可能差到兩到三個數量級。原因是國產交換晶片不同端口的驅動能力偏弱、且端口之間差異巨大,得在 ASIC、PCB 走線、OE 設計三者之間反覆協調,避免「長板擠長板、短板擠短板」。
Micro LED:Slow and Wide 的隱藏帳單
邱晨也談了 Micro LED,本質上是 NPO 的另一種形態——把「快而窄」(112G 或 224G SerDes)換成「慢而寬」(例如 400 個通道 × 低速率)。
Micro LED 的天生優勢是光源、驅動可以用 CMOS 工藝一起做,連發光面的透鏡都能用 CMOS 刻蝕。但他點出一個被普遍忽略的帳:現在所有 ASIC 晶片都是高速率設計,中間一定要有一個 GearBox 做並串轉換——把這個轉換的功耗算進去之後,Micro LED 所謂的功耗優勢會減弱很多。除非單獨為這個場景做一顆晶片。
無源端的挑戰也不小:傳統 NPO 用的 FAU 是十二芯、十六芯,而 400 個通道加上冗餘,至少是一個 20×20 的二維 FAU。
他的小結給了兩個預測:光互連技術下沉到資料中心內、節點內、板卡內是必然趨勢;NPO 技術在國內生態內會全面加速,2027 年規模商用。
6. 新華三阮祖亮:這場論壇唯一的反調——電為根基,CPO 才是終局
如果整場論壇只挑一場聽,我會挑這一場。新華三光系統架構師阮祖亮的題目叫〈電為根基,光為翼展〉,而他上台第一句話就是:
為什麼這麼寫?因為現在所有的技術,哪怕光再發展,光技術還是計算做不到的。所以所有的東西到最後,你依然要靠電來實現。如果你電做不好,光也做不好。
這是一個設備商架構師對著一整個房間的光模組廠商講的話。
2.4T 是怎麼冒出來的
阮祖亮先解釋了一個很多人看不懂的規格:為什麼市場預測裡會出現一個 2.4T?
答案是電上不去。當調製器頻寬只能到 56 GHz、電口只有 224G 的時候,海外廠商提出的過渡方案是改變調製格式——在物理線不變的情況下,透過上層協議變化把有效頻寬拉高,算出來就是 2.4T。他的判斷是:這是一個 224G 與 448G 之間的中間過渡規格,等 448G 到來的時候市場會快速萎縮。
LightCounting 的堆疊圖也印證了這個判斷:2.4T 這一層要到 2028 年才出現,而 3.2T 從 2029 年出現、2031 年成為最大貢獻層。
那個 228% 的 CAGR
阮祖亮引用 Yole Group 2026 年 7 月的預測,這是整場論壇裡最激進的一個數字:
CPO 光引擎營收:2025 年 8,900 萬美元 → 2031 年 1,121 億美元,CAGR 228%。其中 scale-up 用的 CPO 光引擎 CAGR 是 266%,scale-out 是 128%。
他自己的口徑保守一點,講「每年有百分之兩百多的增長」。但他也提醒了一句很誠實的話:AI 目前的熱潮可能不可持續,2028 年面臨「波動」。
台上還有一段很有畫面的自嘲:「平時有很多投資界的朋友,原來根本不看光的,經常就會來一些電話⋯⋯這個市場可能還是對光的技術帶來了太大的期待,希望用光解決所有問題。我覺得這個東西也不太現實。」
224G/lane 的損耗預算:為什麼 NPO「該省的沒省掉」
這是阮祖亮整場最技術、也最有殺傷力的一段。他先給了 224G/lane 各種通道型態的損耗預算:
型態 | 損耗預算 | 拓樸 |
VSR | 32 dB | 無連接器 |
MR | 35 dB | 1 個連接器 |
LR | 40 dB | 2 個連接器 |
Linear | 22 dB | 無 DSP |
重點在最後一行:線性(LPO/NPO)方案因為沒有 DSP 做信號再生,整條電路的驅動能力必須由交換晶片一肩扛下,可用的損耗預算直接砍半,從 40 dB 掉到 22 dB。
他的原話是:「DSP 從再生以後,我就可以用這個信號,回到一個無損的階段,我到下一個階段的時候可以重新計算驅動能力。但是 linear 不行,linear 我要把整個電路所有算在一起。」
而挑戰不在於 22 dB 這個數字本身,而在於——22 dB 要涵蓋交換器面板上所有端口。面板端口有三到四層甚至六層結構,PCB 卻是二維的,正反做滿也只有兩層,必然要跨層,每一次跨層都帶來信號衰減。
解法有三條:把端口立起來(Vertical Line Card)、飛線(Fly-over cable)、或者——飛出去的既然要變光,何不直接在那裡變光?這就是 NPO。
阮祖亮的批評落在這裡:
如果用 NPO 的話,其實我們所有的接口你該省的一點都沒省掉。你如果只是走 PCB 的直線電路,我們損耗的是線性,是可以補償回來的。只有在每一個突變的端口這裡,你才會發現你的信號的劣化是沒有辦法補償回來的。
所以新華三的結論是:CPO 才是走向下一代 448G 之後的解。他也承認 NPO 有它的價值——可維護性、開放解耦、國內生態的紅利——但從純電氣的角度,NPO 並沒有解決根本問題。
這個觀點跟毛明旺給的插損數字其實是同一個現實的兩種讀法:NPO 的 7–9 dB 相比可插拔的 23–26 dB 是巨大的改善,但相比 CPO 的 3 dB 仍有兩倍多的差距。你要把 7–9 dB 當成「已經夠好」,還是「還差一步」,決定了你站哪一邊。
我們在 2026 OCP APAC Summit|CPO / NPO / XPO 三方對談:這不是路線之爭,是 18 個月後那道 409.6T 的牆 裡拆過同一組張力——只是那場是在台北,這場在深圳,而深圳這場多了一個變數叫供應鏈自主。
OCS 的三種真實用法,與它的罩門
阮祖亮花了不少時間講 OCS,而且講得比市場上大部分的樂觀論都清醒。
他先潑了一盆冷水:「OCS 光交換這個話題聽起來很舒服,我們不需要電轉光,但實際上,在目前這個狀態下,它還是起到一個自動配線架的作用。」
現行兩種 OCS 的規格對比:
3D MEMS | 壓電陶瓷 | |
端口數 | 320 × 320 | 384 × 384 |
波長 | 1260–1625 nm | 1260–1625 nm |
插損 | 1.8 / 3.0 dB | 1.5 / 3.0 dB |
串擾 | −50 dB | −50 dB |
切換時間 | 50 ms | 100 ms |
功耗 | 50 W | 140 W |
Google 的三種用法:備份(某張卡宕掉時快速切換)、平滑升級(不同速率的網段混在一起時用 OCS 過渡)、以及最常被討論的大規模訓練。而端口演進是 96×96 → 136×136 → 超過 400×400。
但阮祖亮強調:就算網路外面全是 OCS,tube 裡面仍然有多個電路交換節點,OCS 是對「電」的重新適配,透過 SDN 動態調整拓樸路由——目前來說,OCS 還是離不開電的方案。
他點出兩個罩門:
端口靈敏度:隨著端口數倍增,單端口插損會超過 IM-DD 的規範。解法是 Coherent Lite(但兩側功耗提升、延遲增加)或 SOA(但引入光雜訊、多通道 SOA 成本大增)
鏈路重建延遲:矽光工藝可以把 OCS 本身做到納秒級,但鏈路重建的時延主要出現在光模組與上一跳交換器側。Burst Mode 可以提供超快建鏈,但目前支援速率只有 10 Gbps
他也給了一張很清楚的時間尺度分層:資源層面(秒/毫秒)用 OCS、流量層面(微秒/納秒)用 OFS、封包層面(皮秒)用 OPS。現在的 OCS 只在最上面那一層。
最後他給了一個很有想像力的收尾:矽光 OCS 相較於 MEMS 的最大優勢,是矽光未來能實現光計算——如果哪一天光計算被突破,OCS 與矽光結合就能實現真正的全光計算、全光交換。他自己補了一句:這是願景。
多芯光纖為什麼是 OCS 的解
這一段的邏輯很漂亮。OCS 的端口數看起來很多(320×320),但實際進來的都是單路。Google 的做法是用 FR4 或波分複用,但受限於雷射器數量,成本很高。而多芯光纖可以在相同的鏈路內倍增互連密度——一個 OCS 通道承載多個光通道。
他還提到多芯光纖的另一個好處:在 CPO / NPO 這種設備內部互連場景,多芯光纖可以顯著降低繞纖成本與部署難度。並且點名這是由國內廠商主導的標準,「說明我們中國的廠家走向世界,有了越來越多的話語權」。
至於 Micro LED,阮祖亮的態度是「不完全唱衰,但算完帳之後沒那麼美」。除了跟邱晨一樣點出 GearBox 的功耗問題,他多講了一個被忽略的環節:Micro LED 需要的短距傳像光纖,現在市場價格非常誇張——因為它原本的應用場景要求可靠、親膚,用傳統通訊光纖去做這件事是「大砲打蚊子」。
他在投影片上引的數字是:Micro LED 目前在傳像光纖方案下,2G 頻寬僅能傳輸 20 公尺,無法滿足未來 30 公尺的跨機櫃互連需求,且該光纖對彎曲敏感。光纖設計的需求是:滿足超過 400 路同步傳輸、滿足資料中心佈線彎曲半徑、滿足 30~50 公尺的傳輸損耗、單位空間傳輸密度要能與現有 DR8 方案媲美。
他的最後一句話,是整場論壇最好的一句收尾:
所有的問題我們看起來是光的問題,最後還是要歸於電。但是你電的進步,最後你要把這個電的優勢充分利用出來,我們還得靠光,然後把它盡可能地放大。
7. 海思光電邵海峰:把 NPO 拆到器件層,然後一項一項解
下半場第一位是華為海思光電的邵海峰。如果說上半場講的是「要什麼」,下半場就是「怎麼做出來」,而海思這場是整場論壇技術密度最高的一份。
剪刀差:一張圖說明為什麼光是唯一解
邵海峰用一張標準化的成長曲線(2020 = 1)說明問題的根源:
世代 | 單晶片算力(FP8) | 片間互連頻寬(NVLink) |
A100 · 2020 | 1 | 1 |
H100 · 2022 | 3.2 | 1.5 |
B200 · 2024 | 7.2 | 3 |
Rubin · 2026+ | 25 | 6 |
六年下來,算力成長 25 倍,互連頻寬只成長 6 倍。他給的物理解釋是:算力正比於晶片邊長的平方(面積),互連出口只能正比於邊長(岸線)。這就是剪刀差為什麼會持續擴大,而且沒有辦法靠「多堆晶片」解決。
他還給了模型側的壓力:GPT-4 是 1.8T 參數、GPT-5 是 2~4T、GPT-6 Astra 逼近 10T;國內這條線上,Kimi K2 是 1T / 384 專家、Kimi K3 是 2.8T / 896 專家、DeepSeek V4 pro 是 1.6T / 384 專家、Qwen 3.8-Max 是 2.4T / 512 專家。MoE 架構的特點是把專家分在不同的卡上,每次運算只啟動少量專家——這意味著每一次推理都要做數百次的跨晶片 all-to-all 通信。
超節點規模的競賽也被攤開了:
年份 | 華為 | Vendor N | Vendor G |
2025 | A3:384 卡 | 72 卡 | 64 卡 |
2026 | 950:8,192 卡 | 144 卡 | 2,048 卡 |
2027 | >10,000 卡 | 576 卡 | 9,600 卡 |
FOM:把光互連的四個指標寫成一個式子
邵海峰提出了一個我認為值得整個產業借用的框架:
FOM ∝ [ 頻寬密度(Tbps/mm)× 傳輸距離(m)] / [ 比特功耗(pJ/bit)× 延遲(ns)]
四個指標各自對應一個系統問題:
頻寬密度:晶片每毫米岸線能扇出多少頻寬——決定互連能力能否隨算力繼續擴容
比特功耗:決定光引擎在極致小空間內熱量能否散出
傳輸距離:決定組網能否跨機櫃、跨樓層——決定高速互連域的物理邊界
延遲:決定計算等待與集群同步的木桶短板效應,直接對應 TPOT 與 TTFT
用這個 FOM 去看,光互連的演進路徑就是一條往「高密度、低能效、低時延」推的軌跡:
路徑 | 速率 | 能效 | 密度層級 |
傳統可插拔 | 400G→800G→1.6T→3.2T | 25+ ~ 20 pJ/bit | 低(面板限制) |
LPO 線性驅動 | 800G→1.6T | 約 10~7 pJ/bit | 低 |
NPO / CPO | 3.2T / 6.4T~7.2T | 約 7~5 pJ/bit | 高(板載) |
架構極致融合 | >16T | <1 pJ/bit | 超高(ASIC 邊緣) |
最後一級分成兩條子路徑:Slow and Wide(N × 64G) 與 Fast and Narrow(36 × 448G)。

A3 到 A5:VCSEL 這條路海思已經跑了兩代
華為 A3 超節點(CloudMatrix384)用的是海思自研的 400G SR8 星雲光模組,晶片是 50 Gb/s VCSEL,六吋 GaAs IDM 平台,傳輸距離 200 公尺以上,已現網運行一年。
華為 A5 超節點升級到 800G SR8 星雲光模組,晶片換成 100 Gb/s VCSEL,而且是業界第一個把 VCSEL 多模用在 LPO 架構上的。收益直接標在長條圖上:
延遲:從 oDSP 模組的 110 ns 降到 LPO 模組的 10 ns,降低 90%
功耗:降低 60%
主持人在講評時說了一句很到位的話:大家並不是看不到 VCSEL 的成本與功耗收益,往往擔心的是 VCSEL 的效能。海思這場等於用量產數據把這個疑慮打掉了一半。
而 200 Gbps VCSEL 的突破數據也在投影片上:頻寬 40 GHz(S21 @9 mA)、磨損壽命超過 10 年 @60°C / 9 mA、背對背 BER 約 5×10⁻⁹、傳 30 公尺光纖後約 1×10⁻⁸。
3.2T 與 7.2T:兩顆 NPO 光引擎
3.2T VCSEL 光引擎:32 × 112G、極致功耗 24 W、OIF 尺寸相容。用的是 112G VCSEL/PD 陣列加上 112G 高速線性 oRFIC 電晶片。
7.2T 矽光高密光引擎:36 × 224G、內置光源。演進路徑是三條線同時走:
現況 | → | 下一代 |
224 Gbps,SiPh | → | 448 Gbps,SiPh / TFLN / EML |
36 通道 | → | 72 通道 |
內置大功率光源(CW laser) | → | 矽基異質集成光源 |
內置光源:這是海思最大膽、也最值得注意的一步
這是整場論壇裡我認為最重要的一個技術分歧點。
業界主流做法是外置光源:因為擔心大功率光源的可靠性與高溫效能衰減,所以把大功率光源封裝成類 EML 模組放在面板外面,再透過保偏光纖耦合進矽光引擎。海思的做法是把光源直接做進去——不需要外接光源模組,也不需要保偏光纖,投影片上叫它 Hi-ONE / All in One。
這麼做要解三個問題,而海思三個都給了數據:
第一,高溫效能。海思從第一性原理出發選了鋁量子阱(AlGaInAs,投影片稱 AlQ)做雷射器,而不是行業主流的含磷材料(InGaAsP,稱 PQ)。理由是 AlGaInAs 的能帶結構在高溫下的載子限制更好——投影片上直接對比了兩者在 75°C、接近 200 mW 條件下的功率轉換效率(PCE),AlQ 在高電流端明顯勝出。對 NPO 這種必然存在高溫狀態的場景,這是決定性的。
第二,可靠性。這是鋁材料的傳統弱點,也是行業的共性難題。海思給的實測是 10,000 小時的功率變化率曲線,全程落在 ±10% 的內圈門檻之內,遠優於 ±20% 的外圈規範。
第三,高單模良率。測試條件是 80°C、200 mA,用 3D 光譜圖呈現波長穩定性(起點 1304 nm)。

400G/lane:海思把四條材料路線同時押上
從 7.2T 往 16T 走,Fast & Narrow 這條路要解的是單波 400G。海思把四種調製器方案的頻寬數據一次攤開:
方案 | 頻寬 |
Beyond 200G SiPh | 3dB BW >70 GHz(挑戰 400 Gbps) |
400G EML | 頻寬 >110 GHz |
400G InP MZ | 頻寬 >110 GHz |
400G TFLN | 頻寬 >110 GHz(業界首發 TFLN + SiN/SOI/Ge 混合集成平台) |
而材料平台的矩陣是這樣對位的:
材料 | 100 Gbps/Lane | 200 Gbps/Lane | 400 Gbps/Lane |
GaAs | VCSEL | VCSEL | — |
InP | EML | EML | EML、InP MZ |
SiPh + TFLN + InP | SiPh MZ + CW | SiPh MZ + CW、MRM + Comb | SiPh MZ + CW、TFLN |
這張表的產業意義很直接:海思不是在賭一條路線,而是把 GaAs、InP、矽光、TFLN 四個平台全部自己做,然後讓系統端決定用哪一個。這是一個典型的 IDM 打法,也是缺乏外部供應保障時唯一的選擇。
Slow and Wide:微環與新型光源
另一條路是降低單通道速率、增加空間並行度。海思在這條路上佈局的是:
Comb 光源:200 GHz 通道間隔、10 波、單波功率 8~10 dBm
PCSEL 光源:>400 mW @O 波段、發散角 <1°、低 RIN、窄線寬、高 SMSR
微環調製器(MRM):從 25G、32G、64G 一路覆蓋到 200G;集成演進路徑是 32G×8 → 64G×8 → 64G×16
200 Gbps 高速微環已有 224 Gbps PAM4 眼圖
「去 Serdes、系統到晶片整合」是這條路的關鍵詞——XPU 或交換晶片直接透過 C-Link 接到 Slow and Wide 光引擎,利用光的 WDM 特性把頻寬堆起來。
海思的整體速率路線圖收在一張圖上:800G → 1.6T → 3.2T → 6.4T → ⋯ → 25.6T,對應四條技術路徑:oDSP 直驅、LPO 線性驅動、NPO/CPO 高密光引擎、S&W 極致融合。
8. Marvell:全球視角的分帳——NPO 是疊加,不是取代
Marvell 產品行銷副總裁 Lian Qin 這場的價值在於,它是整場論壇裡唯一一個從「全球市場」而非「中國市場」角度講的。而結論明顯溫和許多。
先把三個 scale 的定義統一
這是需要的,因為前七場講者對這三個詞的用法並不完全一致:
層級 | 範圍 | 名稱 | 特性 |
Tray scale | 托盤之間 | — | 極致效能、最低延遲、最高頻寬、Dragonfly 組網 |
Rack scale | 機櫃內 | Scale up | 垂直擴展,系統如同單一統一 fabric |
Pod scale | 跨機櫃 | Scale out | 水平擴展,毫秒級延遲,分散式工作負載 |
DC scale | 跨資料中心 | Scale across | 區域擴展,連接地理分散的資料中心 |
Marvell 對應的產品線分別是:Marvell Aquila(O-band coherent-lite,2–20 km)、Marvell Ara(1.6T PAM4 3 nm DSP,宣稱業界首個 3 nm 方案)、Marvell ACC / AEC(銅 PAM4,最多 5 公尺)。

三形態的三行帳
Marvell 給的對比表比中國廠商的版本簡潔,但結論一樣清楚:
Pluggable | NPO | CPO | |
通道損耗 | 2X | 1X | 0.5X |
功耗 | TRO 10 pJ/b | 5 pJ/b | 5 pJ/b |
可維護性 | 最佳 | 優於 CPO | 最差 |
市場定位 | scale out 主流 | scale up 主流,通往 CPO 的橋梁 | scale up |
Scale-out:1.6T 的主角是 TRO,3.2T 的變數是 coherent-lite
Marvell 對 scale-out 的判斷相當具體,而且都給了 baud rate 與能效:
方案 | Baud | 能效 | 狀態 |
800G(8×100G/λ PAM4) | 53 GBaud | <16 pJ/bit | 現正大量部署 |
1.6T(8×200G/λ PAM4) | 106 GBaud | <14 pJ/bit | 2025 首次部署 |
3.2T(8×400G/λ PAM4) | 224 GBaud | — | OFC'25 demo |
800ZR Coherent | 118 GBaud | ~35 pJ/bit | — |
1600ZR Coherent | ~240 GBaud | — | — |
而傳輸距離的分界是關鍵:3.2T 的 PAM4 只能到約 500 公尺,1.6T PAM4 可到約 3 公里、800G PAM4 可到約 10 公里。這意味著——當你在 3.2T 世代還想在資料中心內覆蓋 2 公里,就必須把 coherent-lite 從資料中心外面拉進資料中心裡面。
Lian Qin 在台上把這個趨勢講得很明白:可插拔的 PAM 技術到 3.2T 以上只能到 500 公尺,要 cover 兩公里就得考慮 coherent-lite 進資料中心。
他也給了 800G 世代的現況分布:約 95% 是 FRO、5% 是 LPO。然後說了一句我認為是整場論壇最重要的因果推論之一:
大家不要小看這 5%。LPO 的成功是給 NPO 一個很強的技術支援。如果沒有 LPO 的落地,NPO 大家對技術的可靠性和可執行性都是有疑慮的。
換句話說,800G LPO 那 5% 的市占,是 NPO 拿到入場券的原因。
至於 1.6T 世代,Marvell 押的是 TRO(retimed)——功耗 15 W 對比 FRO 的 24~25 W,BER 做到 10⁻¹¹ 已經足夠,預期 1.6T 的 TRO 會成長 50% 以上。
Scale-up:從 rack 到 row 才是那個顛覆性機會
Marvell 對 scale-up 的分析是這場最有商業洞察的一段:
階段 | 規模 | 連接 | 速率 |
機櫃內 scale-up | 數百顆 XPU | Copper、ACC、AEC | 224G → 448G |
跨機櫃 scale-up | 超過 1,000 顆 XPU | 光 | 224G → 448G |
他在台上舉了 NVIDIA 的例子:NVL72 的 scale-up 容量是 scale-out 的 9 倍;到 NVL576 的時候,這個比值變成 18 倍。72 顆 GPU 還能在一個機架內用銅解決(機架內約 5,184 條銅連接),但 576 顆 GPU 需要八個機架,機架之間的距離就不可能再用銅。
而 scale-up 市場的形態遷移是這樣的:100G/lane 完全沒有 NPO/CPO;200G/lane 開始出現;400G/lane 已經過半。Passive copper 的佔比隨 lane 速率提升而遞減。
「疊加,不是取代」
Marvell 的 key takeaways 五條,其中第三條與第五條最值得記:
AI 驅動 scale-out 與 scale-up 的光連接需求
可插拔模組主攻 scale-out,NPO 主攻 scale-up
Scale-out 由 1.6T FRO/TRO 驅動,3.2T 則是 coherent-lite 進入資料中心
Scale-up 的 NPO 生態、商業市場已就緒
Marvell 提供 scale-out 與 scale-up 完整的 EIC 元件
而 Lian Qin 口頭補的那句話,是整場論壇對 NPO 最重要的一個限定:
Scale-up 並不是吃掉 pluggable 的份額,它是疊加。
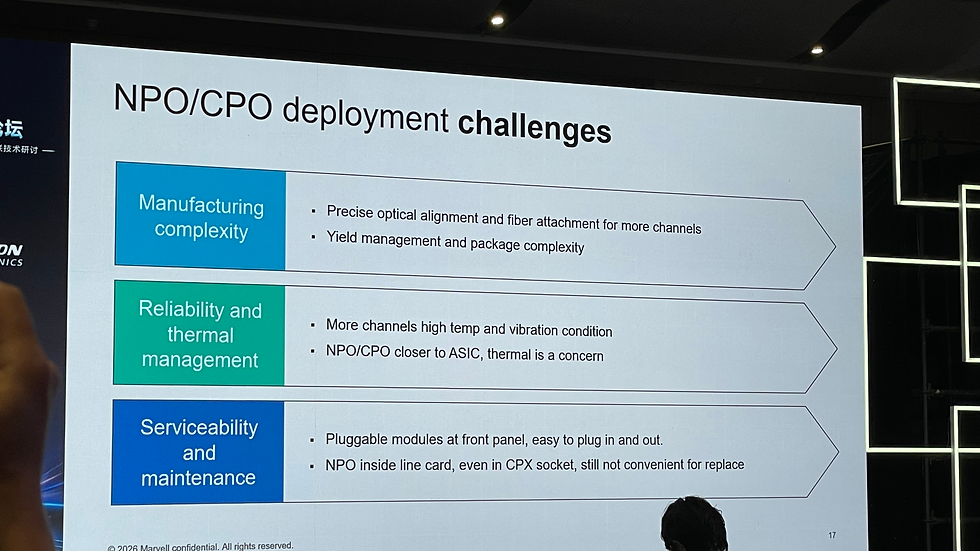
他還誠實地列了 NPO/CPO 部署的三大挑戰——製造複雜度(更多通道的精密光對準與光纖附著、良率與封裝複雜度)、可靠性與熱管理(更多通道的高溫與振動條件,且 NPO/CPO 更靠近 ASIC)、可服務性(NPO 在 line card 內部,即使在 CPX socket 裡,更換仍然不方便)。
生態就緒度的四個角落也被點名了:CPX MSA(2026 OFC 宣布,Samtec / Molex / TE 提供封裝)、PIC(主要模組廠都有自己的 PIC,商用 PIC 有 Xphor、Silith)、EIC(Marvell、Semtech 提供高速 TIA 與 driver)、模組廠(Terahop、Eoptolink、Coherent、CPT、Accelink、華工科技都已啟動 NPO 專案)。
9. 華工正源許文雄:標準線,與 XPO 這條第三條路
華工科技標準部經理許文雄主導過四十餘項國內外行業標準的編制,所以這場的價值在於「標準時程」這種別人講不出來的東西。他投影片上的實際題目是〈CPO/NPO/XPO 多元路徑:重構 AI 智算中心的下一代光連接技術〉。
世代跳轉表
項目 | 當前世代 | 下一世代 |
High-speed SerDes | 212.5G-PAM4 | 425G-PAM4 |
調製器技術 | Silicon Photonics | InP、TFLN |
OSFP 模組 | (8×200G) 1600G | (8×400G) 3200G |
Form Factor | OSFP(8 Lanes) | High-density(64 Lanes) |
最後一行的跳幅最大:從 8 lanes 跳到 64 lanes,這已經不是同一種模組了。
448G:PAM4 還是 PAM6?
這是一個很少被討論但極其重要的分歧:
維度 | 448G PAM4 | 448G PAM6 |
波特率 | ≈ 224 GBd | ≈ 174 GBd |
器件頻寬壓力 | 高 | 中 |
SNR/線性度要求 | 中 | 高 |
產業成熟度 | 較高 | 較低 |
DSP/FEC 複雜度 | 較低 | 較高 |
投影片上的結論是:PAM4 延續現有產業生態,但器件頻寬壓力顯著;PAM6 顯著降低波特率要求,但 SNR 與線性度更敏感。Nyquist 頻率的對照也很殘酷:106.25 Gbps 對應 26.5625 GHz、212.5 Gbps 對應 53.125 GHz、425 Gbps 對應 106.25 GHz。
功耗這張表,把 LPO 的真實價值講清楚了
架構 | 100G/Lane(800G 模組) | 200G/Lane(1.6T 模組) |
DPO | 15 W | 26 W |
LRO | 9 W | 18 W |
LPO | 8 W | 10 W |
但許文雄在台上潑了一盆很誠實的冷水:
我們作為一個模組廠商,可以講我們的成本降低了、單個模組的功耗降低了,但放到整個鏈路側去看的時候,其實它的收益並不會那麼大,因為你的 ASIC 晶片也會因為能力要開得更大而做更多的功耗消耗。
這是模組廠自己說出來的話,所以特別有份量。LPO 省的功耗,有一部分只是從模組轉移到了交換晶片上。投影片上還有一行字:全鏈路成本分析,「50%?20%」——那個問號是他自己打的。
至於整條產業的能效軌跡,2016 到 2026 年間收發器的每位元功耗是:38 → 30 → 27 → 22 → 20 → 17 pJ/bit,而同期交換機容量從 3.2T 走到 102.4T。
1.6T 的距離規格全景
規格 | 距離 | 光源 |
SR | 50 m | 850 nm VCSEL |
DR | 500 m | 1310 nm DML/EML/SiP |
FR | 2 km | 1310 nm |
LR | 10 km | 1310 nm |
ER | 40 km | 1310 nm |
OIF 400ZR | 120 km | 1550 nm IQ MZM |
OpenZR+ / ITU 400G | 500 km | 1550 nm |
而 IEEE 802.3dj 的 3.2 草案已經成熟,規定了 CR/DR/FR/LR/ER;802.3ds 這邊還在吵 860 nm vs 1060 nm。
NPO 標準:四個組織的節奏高度趨同
這是整場論壇裡資訊密度最高的一頁,也是只有標準部經理講得出來的東西:
組織/項目 | 里程碑 |
OIF — 12.8T NPO(涵蓋 6.4T & 7.2T) | 立項 2026.5 → Baseline 2026.11 → Ballot 2027.5 → 發布 2027.8 |
IPEC — 7.2T NPO | 立項 2026.4 → 標準發布 2027.6 → Demo & Test 2027.9 |
Open AI Infra(CCC) — 6.4T/7.2T NPO | 立項 2026.7 → 標準發布 2026.10 → HD Spec 2027 Q1 → 量產商用 2027 Q2(目前 0.7 版) |
ODCC — 6.4T/12.8T UPO | UPO 1.0 發布 2026 Q3 → 6.4T 樣品 2026 Q4 → 6.4T 量產 2027 Q2 → 12.8T(448G) 定義 2027 Q3(目前 0.95 版) |
許文雄自己的評語是六個字:「節奏高度趨同、碎片化、重疊與競爭。」
他還講了一個很重要的觀察:國內的標準團隊跑得比國外快。原因是終端客戶一直在推動標準化落地,導致生態活躍且開放。而 OIF 那邊的進度是:ELSFP spec 已發布、3.2T OE spec 已發布、6.4T NPO spec 立項成功。
CPO 與 NPO 的本質區別
許文雄給了一個乾淨俐落的定義:CPO 與 NPO 的本質區別,是光引擎與 ASIC 是否共用基板。
CPO | NPO | |
信號完整性 | 最優 | 良好 |
可維護性 | 不可熱插拔、散熱困難 | 引擎可插拔、熱源分散 |
生態/產業鏈 | 封閉 | 開放 |
量產製造 | 大規模量產難度高 | 沿用現有成熟供應鏈 |
而 socket 形態上,國內主推 224G LGA socket、海外主推 CPX(Mezzanine)。兩種 Mezzanine 的尺寸分別是 25.3 × 18.9 mm(6 對差分)與 29.6 × 16.5 mm(8 對差分)。他的判斷是:LGA 介面商用落地更快,MEZZ-CPX 方案需要考慮樣品節奏。
2030 年的出貨結構:一張表定生死
這是 LightCounting 對 2030 年各速率端口組成的預測,也是整場論壇裡最能拿來做投資判斷的一張表:
端口速率 | 總量 | Retimed TRX | LPO | CPO |
800G | 44 M | 85% | 11% | 4% |
1.6T | 93 M | 61% | 30% | 9% |
3.2T | 51 M | 29% | 20% | 51% |
這張表把「分層共存」四個字量化了:在 800G 這一代,可插拔還佔 85%;到了 3.2T,CPO 反過來佔 51%。每一代的答案都不同,而且三種方案在任何一代都同時存在。
其他市場數字:AI 光模組 2030 年規模將達 200 億美元以上,較 2021 年成長 7 倍;AI 市場規模首次超過非 AI 應用發生在 2024 年;NPO/CPO 預計 2027 年大規模部署。
XPO:可插拔的第三條路
如果說 NPO 是「往板上移」、CPO 是「往封裝裡移」,XPO 就是「留在面板上,但把它徹底重做一次」。
12.8T XPO 的規格:
64 × 200G PAM4 通道,單模組頻寬 12.8 Tbps
若採用 400G 信號,單模組可達 25.6 Tbps
整合液冷,冷板直接接觸為上下 PCB 提供散熱,最大可支援 400 W 功耗散熱
主板 48 V 供電,模組內部自行轉換電壓
場景覆蓋:Scale Up(<100 m,矽光基線 FRO/RTLR/LPO)、Scale Out(500 m–10 km,矽光與 EML)、Scale Across(80 km + 全相干 ZR)。
許文雄特別澄清:XPO 不是要跟 CPO/NPO 搶高密度卡位,而是「可插拔光模組的下一代」,做場景互補,不是取代現有路線。XPO 1.0 版已在 2026 年 8 月向客戶與同業公布,MSA 有 20 家成員,包含 Accelink、Coherent、Lumentum、Marvell、Molex、O-Net、Source Photonics、Terahop 等。
四大 MSA 的分工也被整理出來了:
MSA | 主要成員 | 定位 |
XPO | 20 家光模組與連接器廠 | 12.8T 液冷可插拔 |
OCI-MSA | AMD、Broadcom、Meta、Microsoft、NVIDIA、OpenAI | 微環諧振器 + 外置光源,支援 NPO/NPC/CPC/CPO |
OPEN CPX MSA | Ciena、Coherent、Marvell、Molex、Samtec、Terahop、Accton、Intel、TE | 6.4 Tbps 可插拔連接器,目標 200G/Lane |
400G Optical MSA | Broadcom、Cisco、MACOM、NVIDIA、Semtech | 400 Gbps IMDD PAM4 optical links |
看 OCI-MSA 那一排成員名單就知道,超大型雲端業者已經全部站到「微環 + 外置光源」這條線上了。
許文雄的判詞是四句話:
CPO/NPO/XPO 多元路徑並行;NPO 是 CPO 規模化前的最優方案,落地選型 CPO 為終極趨勢;XPO 以高密度、原生液冷、熱插拔特性,成為短期主流;NPO 關鍵技術路線的標準化已基本收斂。
10. Lumentum:真正的瓶頸不在架構,在那顆雷射
Lumentum 產品線管理資深總監 Mari Fukazawa 的這場,是整場論壇裡數字最少、但份量最重的一場。
主持人在介紹時放了一個背景:今年上半年 NVIDIA 投資了 20 億美元給 Lumentum。而她的演講從頭到尾在回答同一個問題——為什麼這筆錢會投在這裡。
開場就把定位講清楚了
她一開始就說,這場不聚焦在單一產品,而是要談 AI 基礎建設如何改變光連接,以及為什麼「可擴展性與可製造性」正變得跟元件效能一樣重要。
她對架構的判斷跟論壇的主流一致,但態度更中性:
這裡要傳達的訊息不是某一種架構會取代其他所有架構。不同的架構更可能會共存,取決於成本、距離、可持續性與應用。
而所有架構都逃不掉的五項共同需求是:高速/高頻寬、高輸出功率/高效率、熱管理、可靠性、規模化可製造性。
CW 雷射:把「更多功率」與「更小體積」寫成一個 trade-off
Lumentum 把 CW 雷射的需求做成了一張需求對照表,每一項市場趨勢都對應一個器件要求:
市場/架構趨勢 | 雷射需求 | 技術重點 |
更高密度 | 更高輸出功率 | 高功率操作 |
光學佔位受限 | 在更小體積內做到高功率 | 功率-尺寸最佳化 |
功率/熱限制 | 更高效率 | 光學與電氣效率 |
冗餘度更低的穩定運行 | Kink-free 操作 / 高 SMSR | 穩定單模操作 |
NPO / CPO 整合 | 高溫操作與可靠性 | 熱穩健性與可靠性 |
這張表的第四行值得注意:她提到 AI 集群資料中心的冗餘度比傳統資料中心更低,這意味著單一元件失效的後果更嚴重,所以需要擴大 kink-free 的工作區間、維持高 SMSR。
而第五行呼應了海思那段:LPO 和 CPO 會在靠近熱源的位置運作,所以高溫操作與長期可靠性是必要條件,不是加分項。
投影片上那句總結寫得很好:CW 雷射必須在不增加佔位與熱負擔的前提下輸出更多光功率。
差分驅動 EML:400G/lane 的答案
這是 Lumentum 這場唯一講得很深的技術細節,而且解得很漂亮。
問題是這樣的:隨著資料率提升,EML 需要更高頻寬,但頻寬與消光比(ER)是一個 trade-off——你把頻寬做上去,ER 就掉下來。同時,電介面速率提高之後,共模雜訊已經不能再忽略。
傳統的單端 EA-DFB:DSP 產生的是一對差分信號(V_OUT+ 與 V_OUT−),但單端 EML 只用了其中一個,另外一半的電功率就這樣浪費掉了。
差分驅動 EA-DFB:把兩個電信號同時加到 EA 調製器上,有效驅動電壓變成 V_diff = V_OUT+ − V_OUT−,擺幅直接變成兩倍。兩個好處:
更大的擺幅改善消光比 → 突破 ER 與頻寬的 trade-off
正負信號互相抵消 → 抑制共模雜訊
Mari Fukazawa 在台上給的結論很乾脆:對 400 Gb/s 來說,差分驅動 EML 是最好的解。
從元件效能到可製造性:四個支柱
演講的後半段完全沒有講技術,講的是產能。她的論點是:元件效能只是故事的一半,製造的變異性與可擴展性同樣重要。
四個支柱:
Yield(良率穩定性):效能分布必須與生產的 guard-band 相容。如果良率不穩,出貨就不可能穩
Fungibility(可轉換性):不同架構的選擇意味著產品組合會一直變動,產線必須有敏捷性與可調整性,跨多個業務與產品共用製程
Scalability(可擴展性):後段製程如測試、外觀檢驗必須流線化
Reliability(可靠性):現場會存在巨量的光連接,即使很小的失效率也會變得顯著
產能:四座廠同時擴,加上一座新買的
Lumentum 的 InP 產能佈局是:Sagamihara / Takao(日本,主力)、San Jose(美國)、Caswell(英國) 三地同時擴產,加上最近宣布收購的 Greensboro, NC(美國,來自 Qorvo,含工程師團隊)——這座新廠 CY28 開始出片。
但她強調了一句很重要的話:擴產不只是增加設備或產線。「EML 和雷射晶片是最難生產的半導體之一」,Lumentum 有 30 年的經驗與累積的專業知識。
這一段呼應了主持人在總結時說的話——那段話我認為是整場論壇最尖銳的產業判斷:
最近矽光很熱,熱到甚至有人說將來都可以用矽光,光源供應就不是問題了,不再依賴那些傳統的光電大廠。這裡面有一個巨大的誤解:矽光甚至都不能發光。所以將來就算用矽光,你會發現依然有基於磷化銦的光源,半導體雷射會成為產業的瓶頸。
這件事我們在 【CPO 拆解 3/6】CPO 最脆弱的一環,是那顆雷射 與 禁得了模組,禁不了基板:光通訊的勝負手已經下移到磷化銦 兩篇裡都拆過。深圳這場論壇等於用另一個角度再確認了一次。
11. 長飛張磊:光纖端的答案,以及那句歷史使命
壓軸是長飛光纖基礎研發部經理、空芯光纖產品線總經理張磊。他上台第一句話很誠實:「因為我是最後一個,壓力很大。」
但這場其實是整場論壇裡資料最扎實的一份——因為光纖是唯一一個已經在現網跑、有實際交付里程的環節。
先把錢的帳算完
長飛的資本支出預測比論壇裡任何一場都詳細:
年份 | 五大巨頭合計資本支出 | 年增率 |
2024 | 2,610 億美元 | — |
2025 | 4,490 億美元 | +72% |
2026E | 8,050 億美元 | +79% |
2027E | 1.1 兆美元 | +37% |
2028E | 1.35 兆美元 | +23% |
2026 年各家指引:Amazon 2,000–2,200 億、Alphabet 1,950–2,050 億、Microsoft 1,850–1,900 億、Meta 1,300–1,450 億、Oracle 400–500 億。
而 2026–2030 年全球 AI 基建累計投入預測是 5.5 兆美元(摩根大通,較此前上調 4,000 億)。光模組市場則是 2023 年 62.5 億美元 → 2029 年 258 億美元。
密度:這是光纖端最急的一件事
張磊把問題拆成四個共性瓶頸:能耗、密度、頻寬、時延。而密度這一塊,他給的數字最有衝擊力。
前面板密度:
對比維度 | QSFP-DD/OSFP | MPO-12 | MMC-32(VSFF) |
端口間距 | 22.3 / 11.1 mm | 3.8 mm | 1.3 mm |
面板尺寸 | 24.3 × 17.2 mm | 12.8 × 9.4 mm | 4.2 × 9.6 mm |
1U 端口數 | 32–36 | 72 | 264(×3.7) |
1U 光纖芯數 | 256–576 芯 | 864 芯 | 6,336 芯(MMC-24) |
32 × 1.6T / 1U = 51.2 Tbps,而單模組功耗 23–25 W——端口密集排布阻礙氣流,散熱功率密度與面板布局必須協同設計。
CPO 在這一格的收益是量化的:電信號路徑從 30 cm 縮到 4 cm、單端口功耗從 30 W 降到 9 W,降幅 70%。
光纖用量:
場景 | 單機架光纖芯數 | 倍數 |
傳統雲機架 | 40–80 芯(20–40 根) | 1× |
AI 智算中心 | 800–1,000 芯 | 10–17× |
高端 AI 集群 | 3,600–7,200 芯 | 36× |
萬卡 GPU 集群內部互連需要約 20 萬根光纖;單園區光纖總量可達數百萬根。單 GPU 的光模組搭載量從 1.6 增至 5 單元(H100 是 1:3、B300 是 1:4.5、ASIC 最高到 1:8)。
樓宇之間的光纜芯數也在跳級:1,728 芯(直徑僅 19.8 mm)已規模商用、3,456 芯批量部署、6,912 芯成為 AI 園區主流,往上還有 13,824 芯。而 2026 年全球光纖總需求超過 6.7 億芯公里,資料中心光纖需求年增 69%。
時延:空芯光纖的物理紅利
這一段是長飛真正的殺手鐧,而且論證鏈很完整。
問題端:跨資料中心分散式訓練的時延敏感度有多高?投影片引用了一篇 arXiv 論文的模擬結果——時延從同一資料中心增至 40 ms 時,訓練的平均迭代時間最高放大約 9 倍。在 1,000 公里的跨域場景,訓練時間乘數從 SMF 的 26 倍降到 HCF 的 18 倍。
物理端:光在玻璃芯中的傳播速度是 0.67c,在空氣芯中是 0.99c。差距換算下來是:
傳輸時延降低約 33%
每公里省下約 1.5 μs
80 公里的跨園區鏈路,單程省約 120 μs
部署端:這是最有說服力的部分。長飛已完成 18 條空芯光纖鏈路交付,其中中國(含香港)15 條。時間軸從 2024 年 6 月的東莞 10.3 km 一路走到 2026 年 8 月,最長的一條是 2026 年 1 月武漢的 413 km,另外還有海外 114 km、杭州 95 km、香港 41.87 km 等。
而空芯的效能紀錄也在刷新(此處引自新華三阮祖亮的投影片,兩家數字可互相對照):實驗室損耗已實現 0.04 dB/km,熔接損耗平均 0.05 dB,DCI 千公里級示範的平均損耗 0.12 dB/km。
頻寬:色散才是真正的天花板
張磊點出一個很多人會忽略的物理限制:頻寬主要受色散限制,而色散容限與傳輸速率的平方成反比。
單模光纖的色散曲線在 1250 nm 是約 −4 ps/(nm·km),1300 nm 附近過零,1650 nm 到 +20 ps/(nm·km)。而空芯光纖(HCF)全波段幾乎水平,落在 −1 到 +1 ps/(nm·km) 之間。這意味著單波 200G/400G 的 WDM 信號在 O 波段的傳輸距離不再被色散綁死。
多模端的限制更嚴苛:單波 200 Gb/s 時,標準 OM4 只支援 40 公尺鏈路,而且對光源的模式頻寬與譜寬要求極高——這正好解釋了為什麼美團要花力氣去推 eSR 標準。
三條路,各自對位到哪一層
長飛給的新型光纖解決方案是一張很清楚的對位表:
問題 | 解法 | 對位層級 |
交換器前面板密度 | CPO + 光纖插頭介面 | Scale-up |
跨樓宇光纜太粗 | 小外徑細徑光纖(250 → 200 μm,截面積縮小 36%,同截面數量提升約 1.5 倍) | Scale-out / Scale-across |
單纖傳輸密度 | 多芯光纖(MCF),單根光纖承載 4~38 個光通道 | Scale-up 內部互連 |
DCI 跨園區時延 | 空芯光纖(−33%,適用 10 km~1,000 km) | Scale-across |
集群內部時延 | 空芯(機架間 −30%,GPU 利用率提升 15–25%) | Scale-up / Scale-out |
CPO 內部保偏 | PMF 保偏光纖 + G.657 抗彎光纖(7.5 mm 最小彎曲半徑) | CPO 封裝內 |

CPO 為什麼對光纖「更挑剔」
張磊講了三個很具體的理由:
偏振敏感:矽光波導只傳 TE 基模,偏振態一旦漂移,調製效率與鏈路品質立刻衰落——所以外置光源到矽光引擎之間必須全程保偏
彎曲密集:封裝邊緣數百根光纖要在小半徑轉彎,普通光纖在這種場景下彎曲損耗飆升——所以要 G.657 抗彎
密度極限:204.8T 的前面板需要引出數千根光纖,纜徑與彎曲半徑直接決定裝不裝得下
而 DWDM 下沉到 DCN 是另一個趨勢:MRM 微環調製器原生支援波分且易於擴展(短板是熱敏感性高),投影片上引用了 Lightmatter 用於 CPO 的 16 波長 DWDM 光引擎。
那句歷史使命
張磊最後的總結只有一句話,但這句話是整場論壇最好的收尾:
傳統用於解決長距離通信的光纖,在 AI 時代將承擔起短距高速數據互聯的歷史使命。
12. 總結

第一,NPO 的「持久性」是真的,但理由跟大部分人講的不一樣
市場上談 NPO 常用的理由是「CPO 還沒準備好,所以先用 NPO 過渡」。這個說法在這場論壇裡被三次修正。
美團說它從過渡方案變成長期路線;華工正源說 NPO 覆蓋主流、CPO 突破高端、長期分層共存;Marvell 說它是疊加不是取代。而最誠實的是烽火邱晨:NPO 在中國之所以會成為持久形態,是因為它同時解了技術問題與供應鏈問題——224G 銅纜撞牆是技術理由,國內 PAM4 DSP 是瓶頸是產業理由,而 NPO 是唯一一個同時滿足兩者的答案。
這代表什麼?代表中國的 NPO 需求不會因為 CPO 成熟而消失。因為讓 NPO 成立的那個產業條件(開放解耦、沿用現有模組供應鏈、不綁定單一交換晶片廠)不會因為 CPO 良率爬坡而改變。
華工正源那張 2030 年出貨結構表是最好的註腳:在 3.2T 世代,CPO 佔 51%,而可插拔加 LPO 仍佔 49%。沒有誰吃掉誰。
第二,新華三的反調值得認真對待,因為它指向 448G
阮祖亮講的那句「NPO 該省的一點都沒省掉」,在 224G 世代聽起來像抬槓,但把它放到 448G 的脈絡裡就變成一個很尖銳的警告。
看數字:224G/lane 的線性方案損耗預算只有 22 dB,而 NPO 的實測插損是 7–9 dB——還有 margin。但到了 448G,Nyquist 頻率翻倍到 106.25 GHz,通道損耗會急遽惡化,而 NPO 的介面突變點(socket、連接器、封裝邊緣)帶來的信號劣化是補償不回來的。
換句話說,NPO 這條路的壽命,取決於 448G 什麼時候真的需要部署。華工正源的標準時程給了答案:ODCC 的 12.8T(448G)UPO 定義在 2027 Q3 才會開始。所以 NPO 至少還有 2026 到 2029 這個完整的窗口,而海思的路線圖也是把 448G 放在 2030+。
在這個窗口內,NPO 是安全的。窗口關上之後,新華三是對的。
第三,真正的勝負手在兩個「不性感」的環節
整場論壇裡,最不像重點、但實際上決定成敗的是兩件事。
第一件是雷射晶片。Lumentum 這場沒有給幾個數字,但它講的每一件事都是門檻:EML 是最難生產的半導體之一、30 年累積的專業知識、四座 InP 廠同時擴產、CY28 才會出片的新廠。而海思花了整整四頁講內置大功率光源的三個挑戰——高溫效能要選鋁量子阱、可靠性要做到 10,000 小時、單模良率要在 80°C / 200 mA 下站得住。
主持人那句「矽光甚至都不能發光」是整場最清醒的一句話。不管架構怎麼演進——可插拔、LPO、NPO、CPO、XPO——每一條路的起點都是一顆磷化銦或砷化鎵雷射。而這個環節的產能建設週期是以「年」計的。
第二件是光纖與連接器。長飛那張表把它講白了:AI 機架的光纖芯數是傳統的 10 到 36 倍,萬卡集群要 20 萬根光纖,園區之間要 6,912 芯光纜成為標配。而 CPO 對光纖的三個新要求(保偏、抗彎到 7.5 mm、細徑到 200 μm)全部是材料與製程問題,不是設計問題。
這兩個環節的共同點是:它們都不在「架構之爭」的戰場上,但不管哪一種架構贏,它們都會賣得更多。
第四,Scale-across 是被低估的那一塊
論壇裡有三家不約而同地指向同一件事,但市場討論度遠低於 CPO。
烽火給的數字是 Scale Across 市場 CAGR 超過 55%,高於資料中心內互連的 40%。Marvell 說 3.2T 世代的 PAM4 只能到 500 公尺,要覆蓋 2 公里就得把 coherent-lite 拉進資料中心。長飛給的物理根據是:跨資料中心訓練在 40 ms 時延下迭代時間放大 9 倍,而空芯光纖能省下 33%。
這三件事串起來的結論是:當單一園區的電力與土地撐不住十萬卡集群時,「把多個資料中心當成一個」就是唯一的路,而這條路的技術棧(相干下沉、空芯光纖、超低時延盒式設備)跟資料中心內是完全不同的一套。
第五,對台灣供應鏈的意義
這場論壇是一場中國供應鏈的內部對話——十一場裡有九場是中國廠商或中國廠商的視角,Marvell 與 Lumentum 是唯二的外部聲音。但台灣供應鏈在這張圖上的位置其實非常清楚。
第一層,被直接點名的環節。美團那頁講 224G/lane 封裝路線時寫的是「CoWoS 已成熟量產、CoPoS 處於良率爬坡期」——這兩個詞都是台積電的。而 NPO 與 CPO 共同需要的先進封裝、矽光平台、測試與耦光,正好是台灣這幾年在 SEMICON Taiwan 2026 矽光子國際論壇 上被反覆討論的那一組能力。
第二層,不受架構之爭影響的環節。FAU、連接器、耦光、保偏光纖組件、外置光源模組(ELSFP)——這些在 NPO 要用、CPO 要用、XPO 也要用。騰訊、烽火、海思三家都在講「壓合」「繞纖」「髒污」「端面」這些問題,而這正是台灣光被動元件廠的主戰場。
第三層,那個窗口期。華工正源的標準表告訴我們:NPO 的四個標準組織全部在 2027 年上半年發布標準、2027 Q2 進入量產商用。騰訊的 512 卡超節點部署排在 2027 Q1。烽火預測 NPO 在 2027 年規模商用。三個獨立來源指向同一個時間點——2027 年是 NPO 的量產元年。
這意味著:規格驗證與樣品交付的窗口是 2026 年下半到 2027 年上半。如果一家台廠現在還沒有 NPO 相關的樣品在客戶端測試,2027 那一波就趕不上了。而外置光源(ELS/ELSFP)這條線的窗口更早——因為它是 NPO 與 CPO 共用的,而且騰訊的投影片上明確寫著「NPO 採用的外置 ELS 可插拔」。
至於 448G,那是 2029 到 2030 的事,現在佈局的是材料(TFLN、InP MZ)與封裝(72 通道、二維 FAU)。
最後一句話留給邵海峰投影片上的那句:不在於我們能堆出來多少晶片,而在於讓這些晶片能協同工作。這場論壇十一份投影片,講的其實都是同一件事——把成千上萬顆晶片變得像一顆晶片,而中間那條路,只能是光。
相關閱讀
2026 OCP APAC Summit|CPO / NPO / XPO 三方對談:這不是路線之爭,是 18 個月後那道 409.6T 的牆:同一組路線張力,在台北的另一種講法
銅纜撐不住 AI 之後:scale-up 光互連的七條路,與各撞一堵牆的兩種活法:Fast & Narrow 與 Slow & Wide 的完整拆解
【CPO 拆解 1/6】可插拔光模組撞牆了嗎?看懂 CPO 之前,先看懂這道牆:這道功耗牆的第一性原理
【CPO 拆解 4/6】光纖對晶片:CPO 裡最不性感、卻卡住所有人的那一步:耦光與 FAU 為什麼是台廠的機會
CPO 終於不再是「狼來了」:LightCounting CPO/NPO 大會的六個真實訊號:同一家研究機構在另一場會議上的判斷
2026 AI 基建必看!光通訊與 CPO 產業鏈全圖(附最新概念股名單):整條供應鏈的對位圖
本文所有硬數字均取自 2026 年 9 月 9 日 CIOE 芯·光論壇現場投影片,講者口述與投影片數字不一致時以投影片為準。演講內容為各講者立場,不代表 Simple Tech Trend 觀點。
本文僅供技術與產業趨勢分析,不構成任何投資建議。




留言